Автоматический поиск документов из 1С:ДО
Контекстный RAG-ассистент над архивом 1С:Документооборот: точные факты из каталога, текст файлов из гибридного поиска, ответы со ссылками на источники и без выдумок.
О проекте
Обратились с запросом: дать сотрудникам возможность спрашивать по архиву 1С:Документооборот обычным языком. Какие файлы входят в карточку и какая редакция действующая, что менялось между редакциями, кто и с какими замечаниями согласовывал документ, что с ним связано и как ответить на замечание. Каждый ответ должен вести к источнику, а при отсутствии данных система обязана прямо об этом сказать.
Это AI/RAG-ассистент поверх боевой базы 1С:Документооборот КОРП 3.0. Каждую ночь система выгружает карточки, файлы, редакции и их тексты, визы, задачи согласования, переписку и связи документов через OData, складывает их в собственный каталог на PostgreSQL, индексирует текст в Qdrant и отвечает на вопросы через локальную LLM. Главный принцип: языковая модель не является источником фактов. Существует ли документ, какие у него файлы, сколько редакций у каждого файла и кто согласовал последним, определяет код точными запросами к каталогу, текст файлов приходит из гибридного поиска, а модель только формулирует ответ по пронумерованному контексту. Прямого доступа к базе 1С нет по условиям заказчика, поэтому выгрузка построена как отдельный отказоустойчивый конвейер для архива около 182 тысяч документов. Развёртывание on-prem: Docker Compose или Kubernetes, модели Qwen3.8-27B и BAAI/bge-m3 на сервере моделей в контуре, данные не покидают периметр.
Технологии
- Python
- FastAPI
- PostgreSQL
- Qdrant
- SQLAlchemy
- Alembic
- React
- TypeScript
- Vite
- React Flow
- Qwen3.8-27B
- BAAI/bge-m3
- fastembed
- Jina Reranker
- 1С OData
- APScheduler
- Prometheus
- Docker
- Kubernetes
Что разработано
- Бэкенд на FastAPI (Python 3.12) с асинхронным PostgreSQL (asyncpg, SQLAlchemy), миграциями Alembic и JWT-авторизацией
- OData-клиент к 1С:ДО КОРП 3.0: постраничное чтение, повторы, адаптивное уменьшение страницы при 5xx, чтение $metadata, поимённый выбор полей
- Потоковый конвейер выгрузки: скан ключей и DataVersion, индексы файлов, виз и связей, затем документы пачками по 500 с фиксацией каталога и индекса по каждой пачке
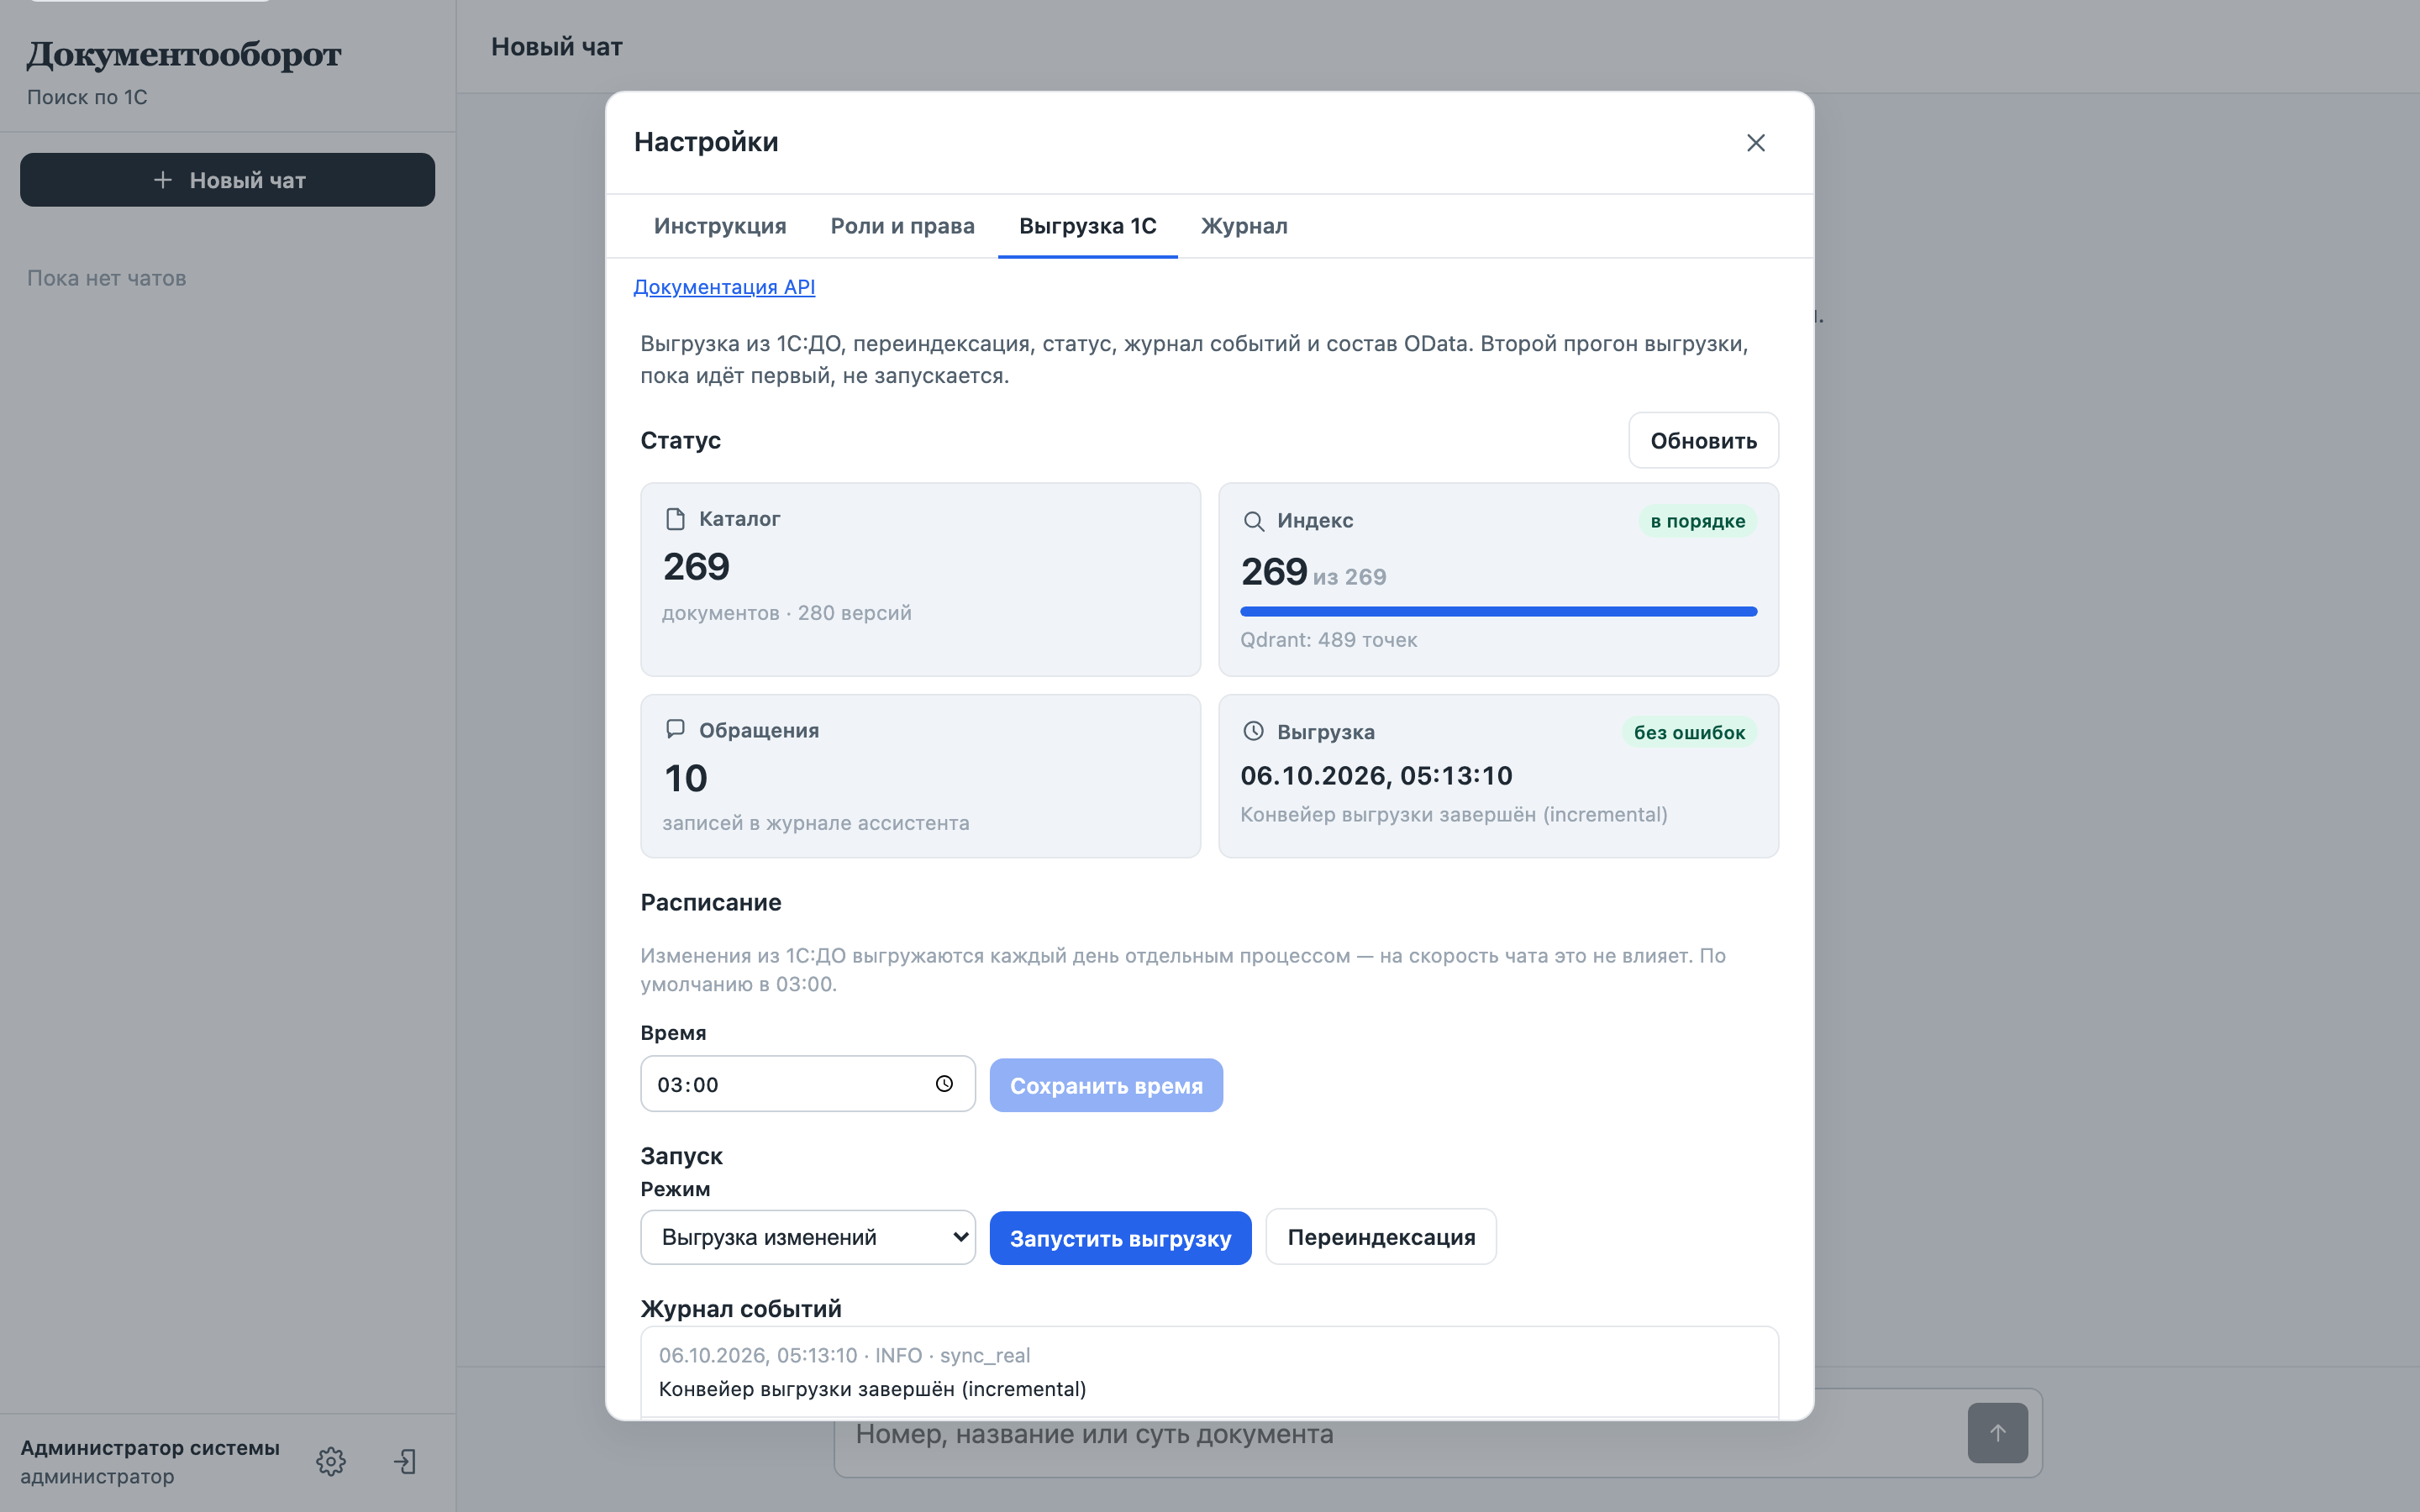
- Отдельный процесс-воркер с ночным инкрементом по расписанию (APScheduler) под Postgres advisory lock: ручной и плановый прогоны не накладываются
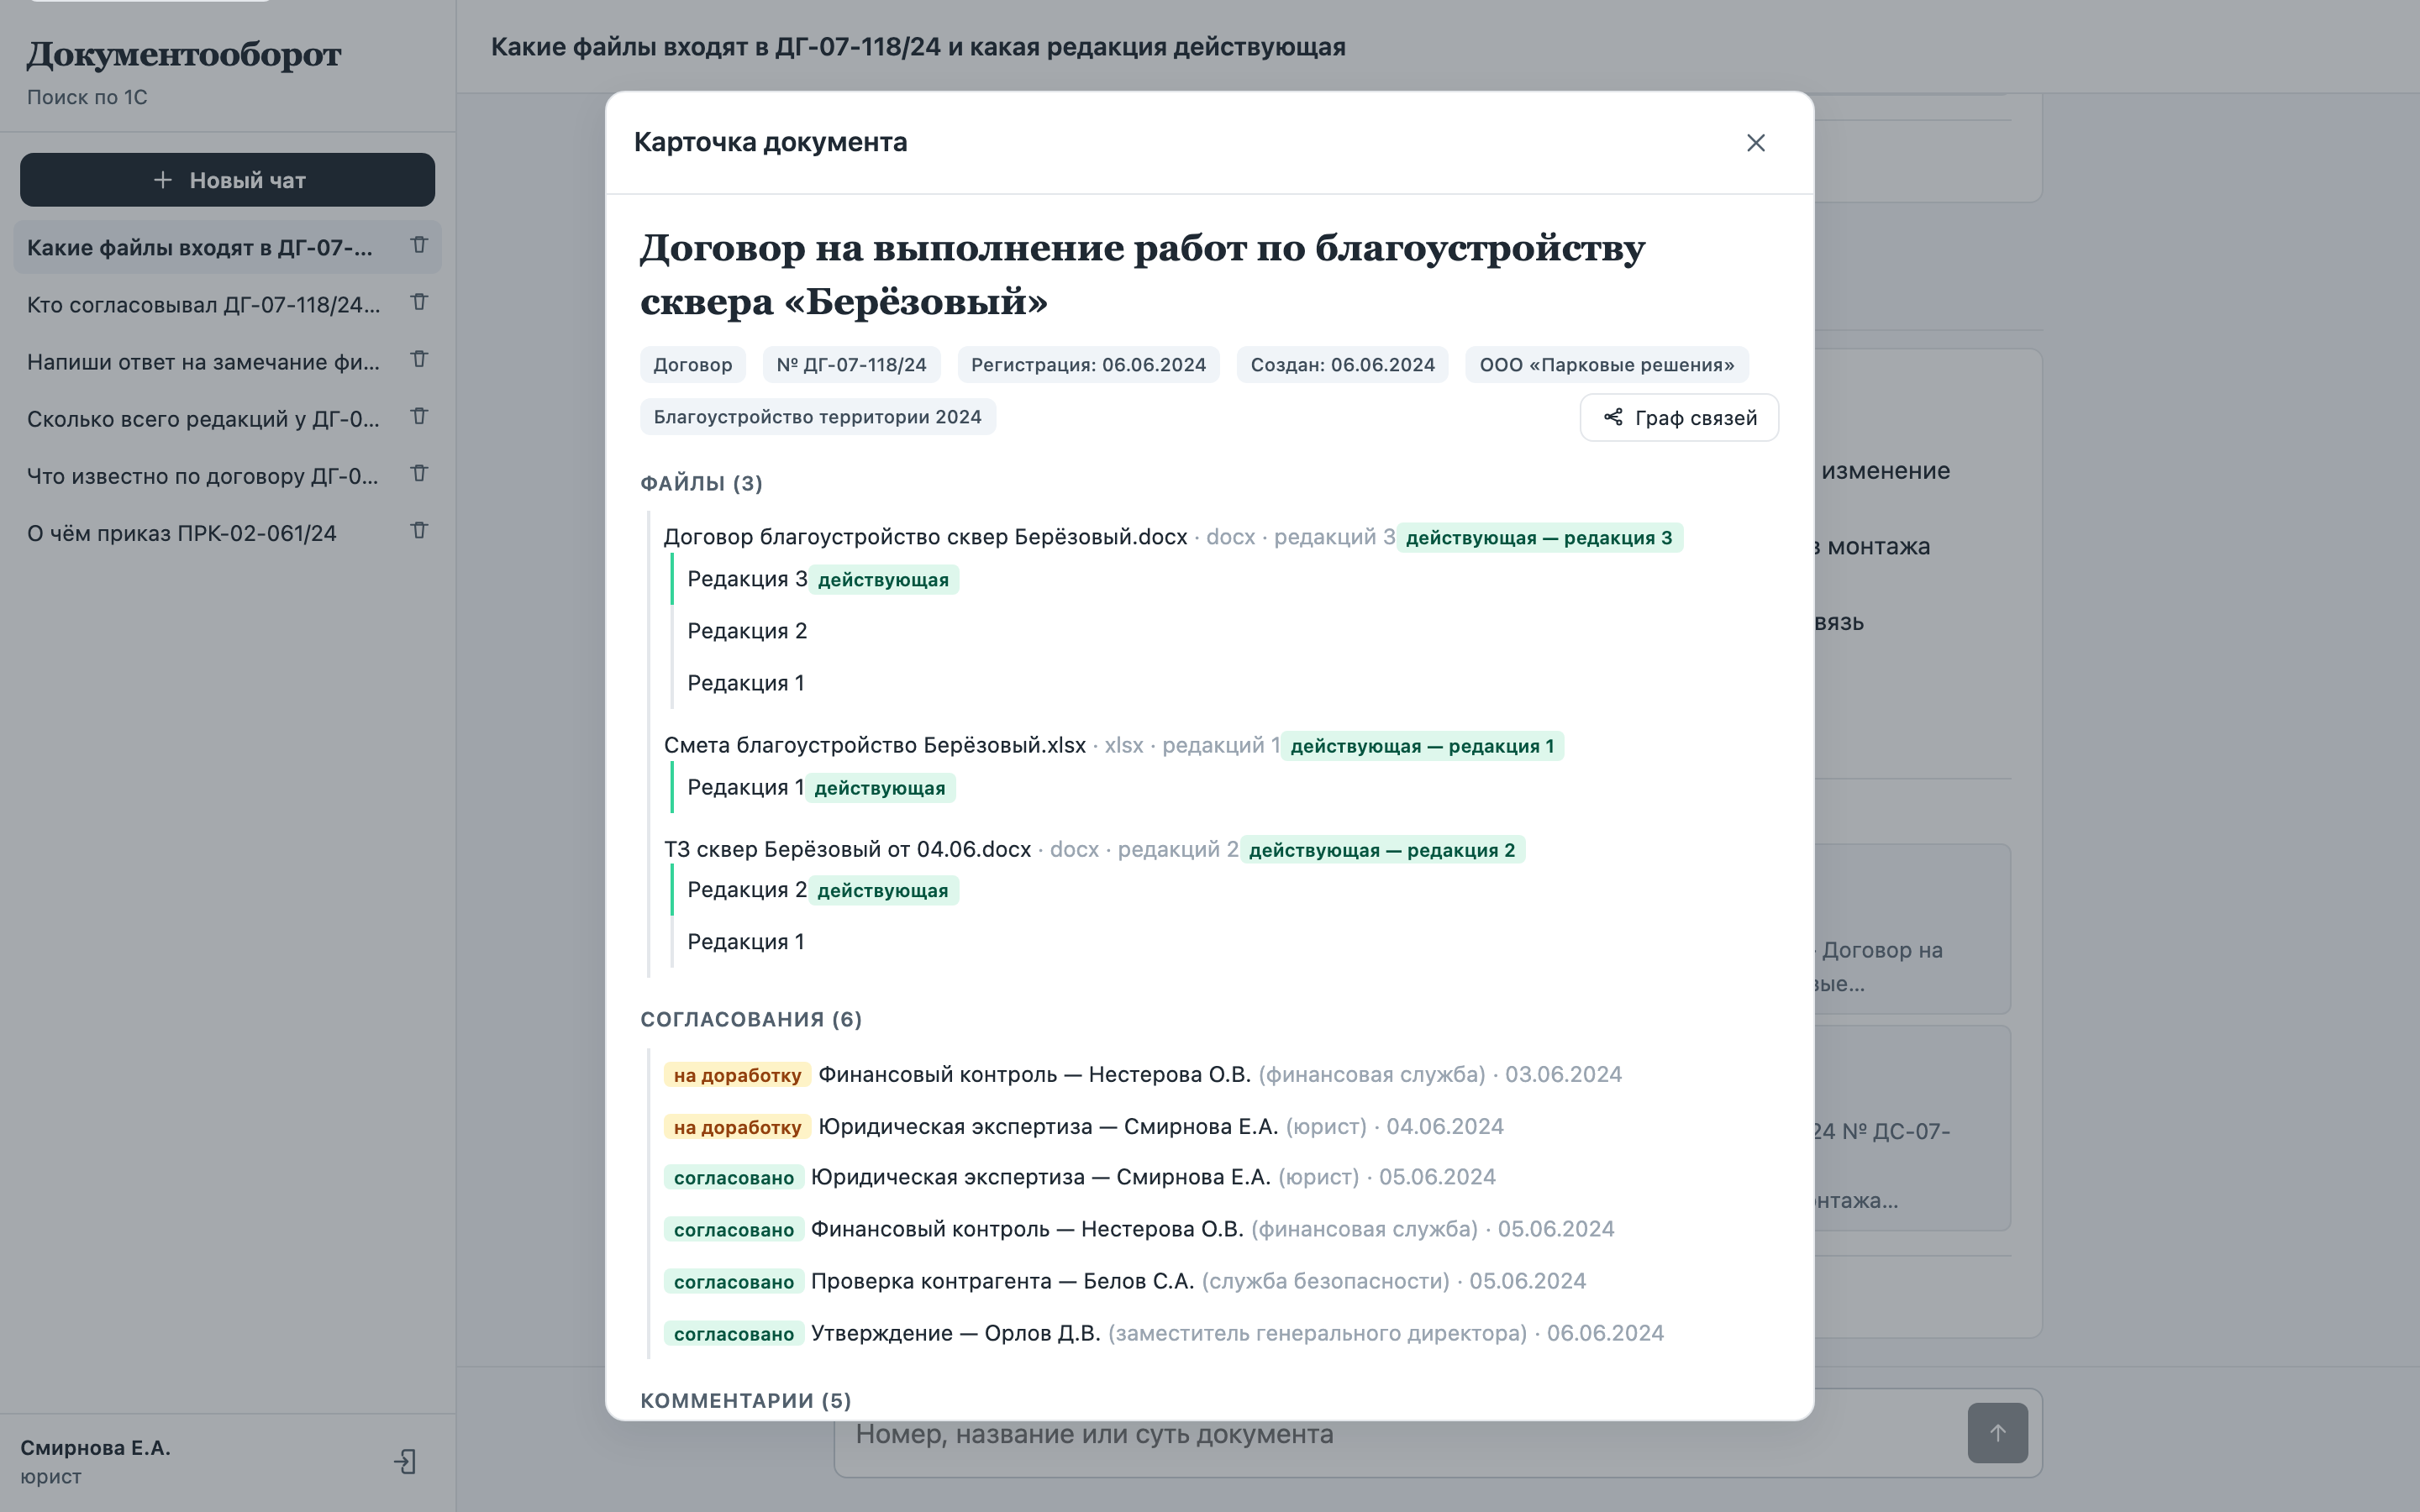
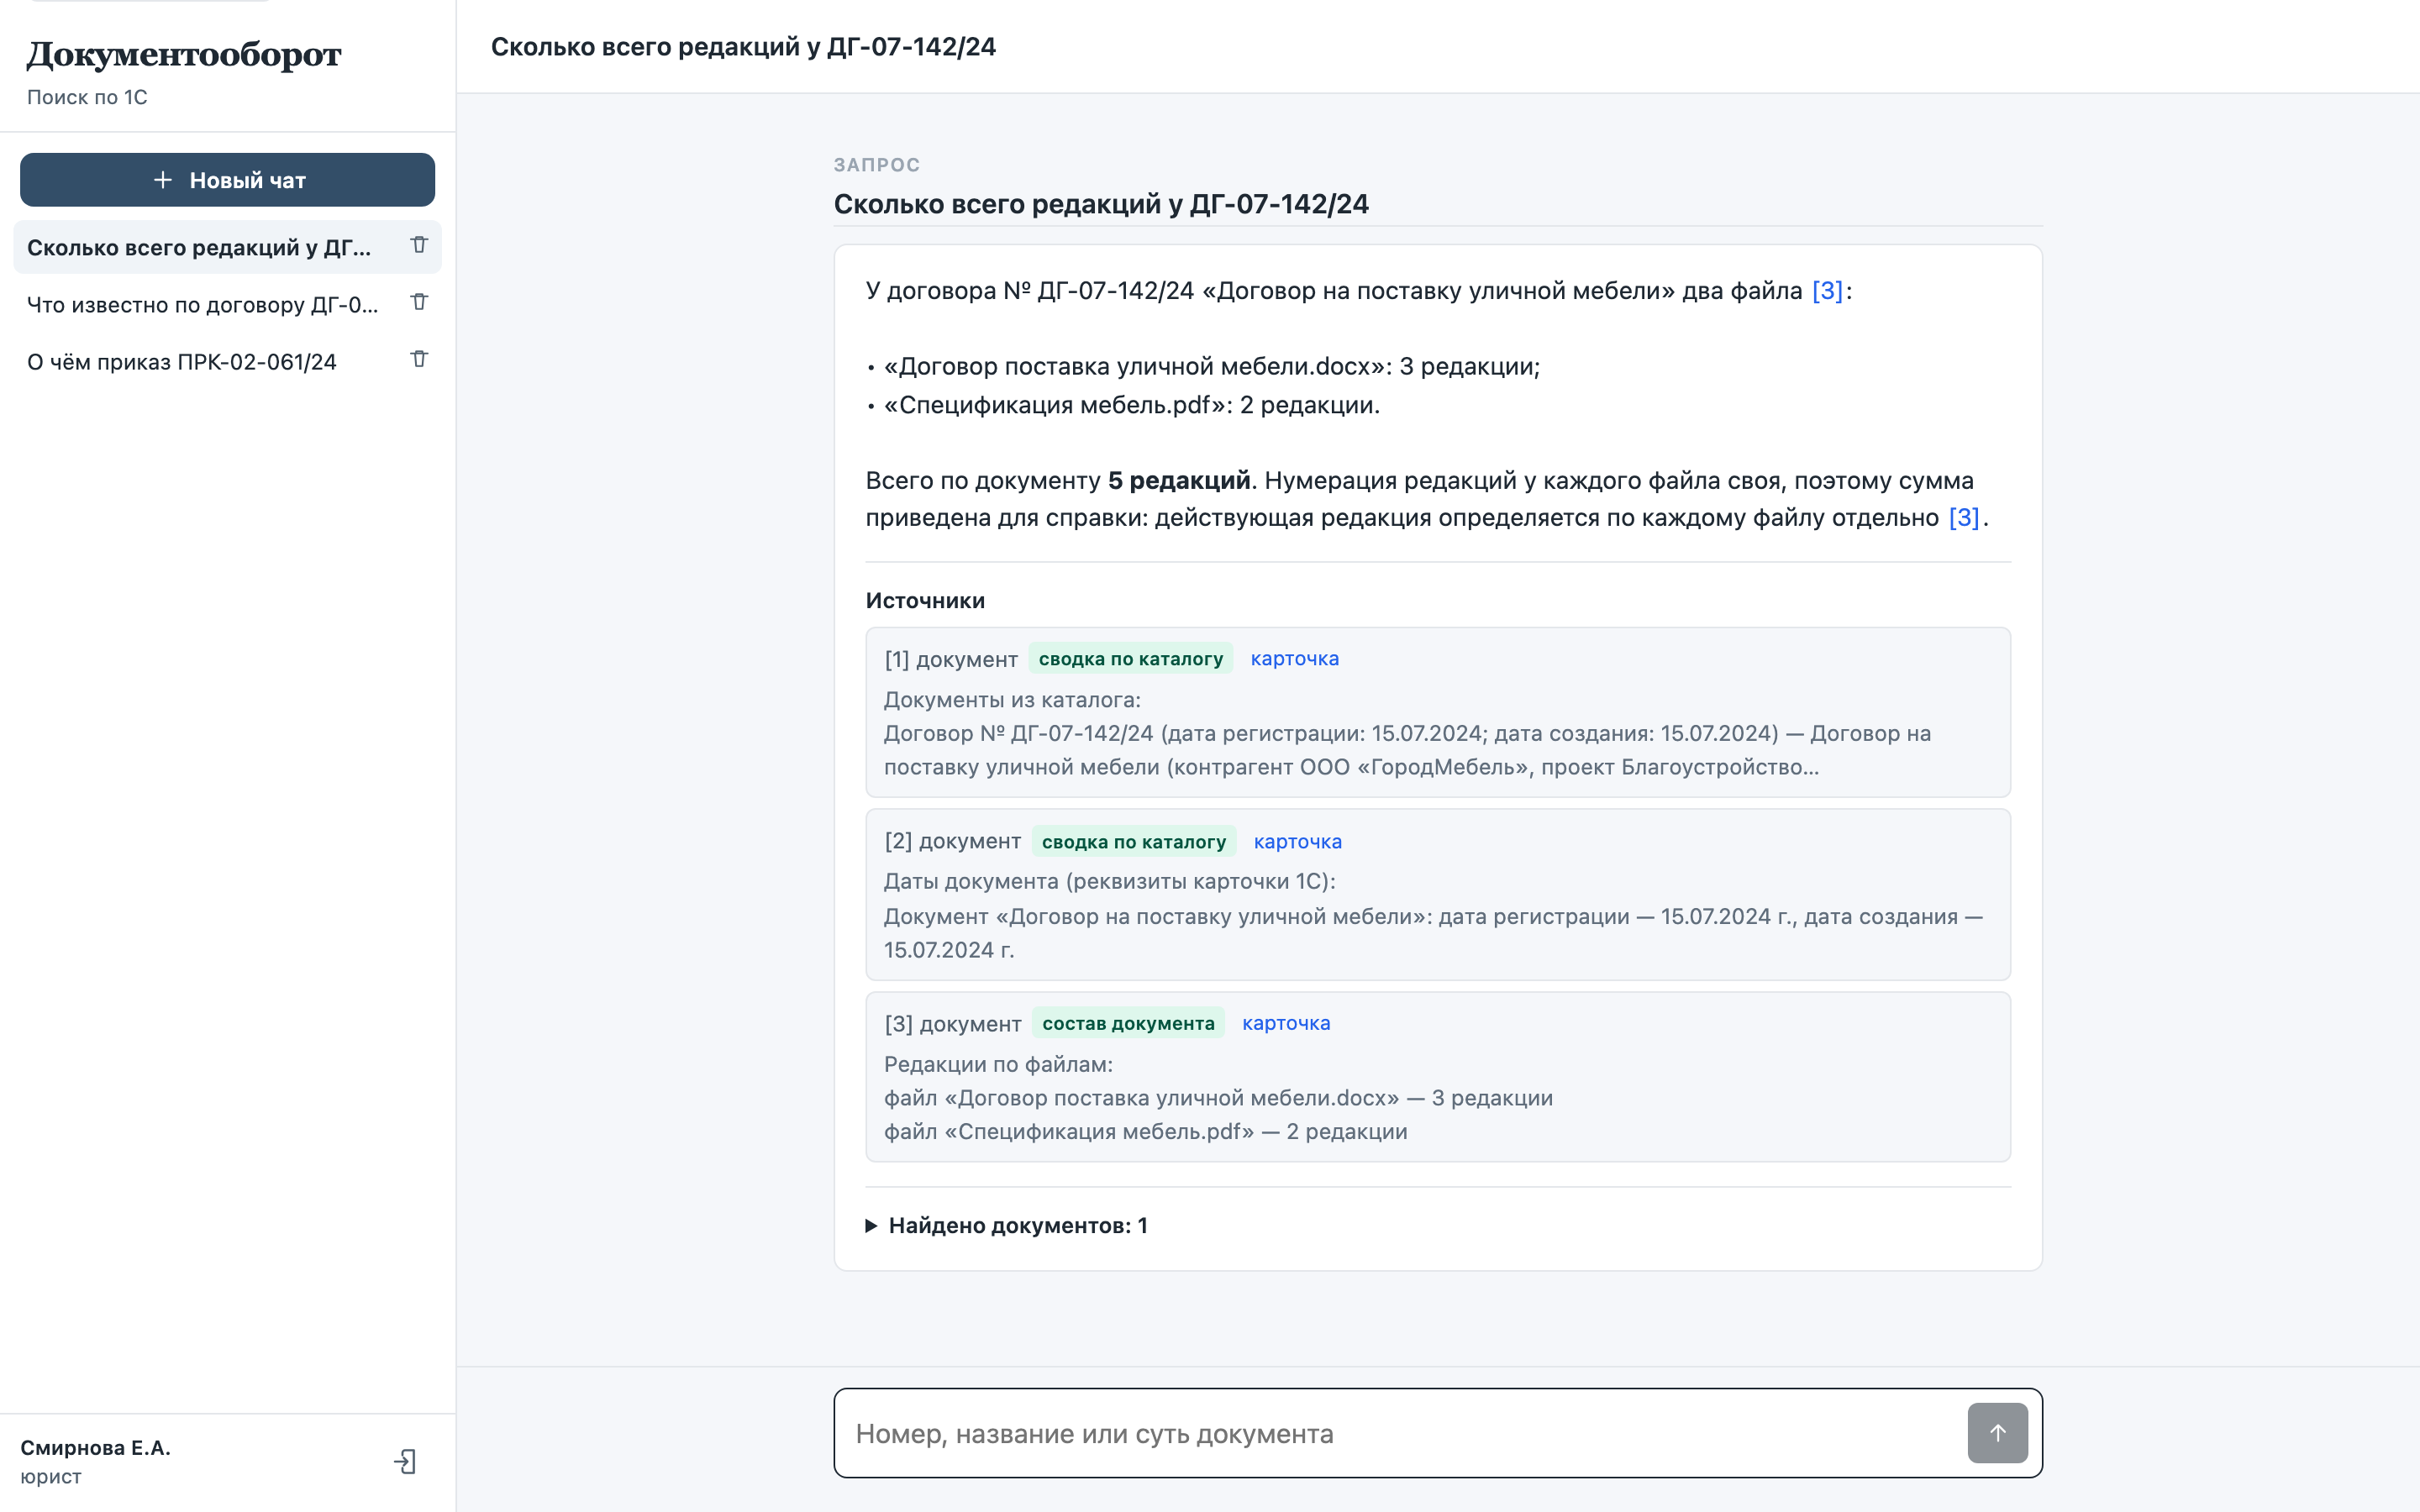
- Каталог со схемой «документ, файл, редакция файла»: у каждого файла своя нумерация редакций и своя действующая редакция, как в 1С
- Полнотекст редакций из регистра «ТекстыВерсийФайлов» (бинарь файла OData не отдаёт); дата регистрации и дата создания хранятся раздельно
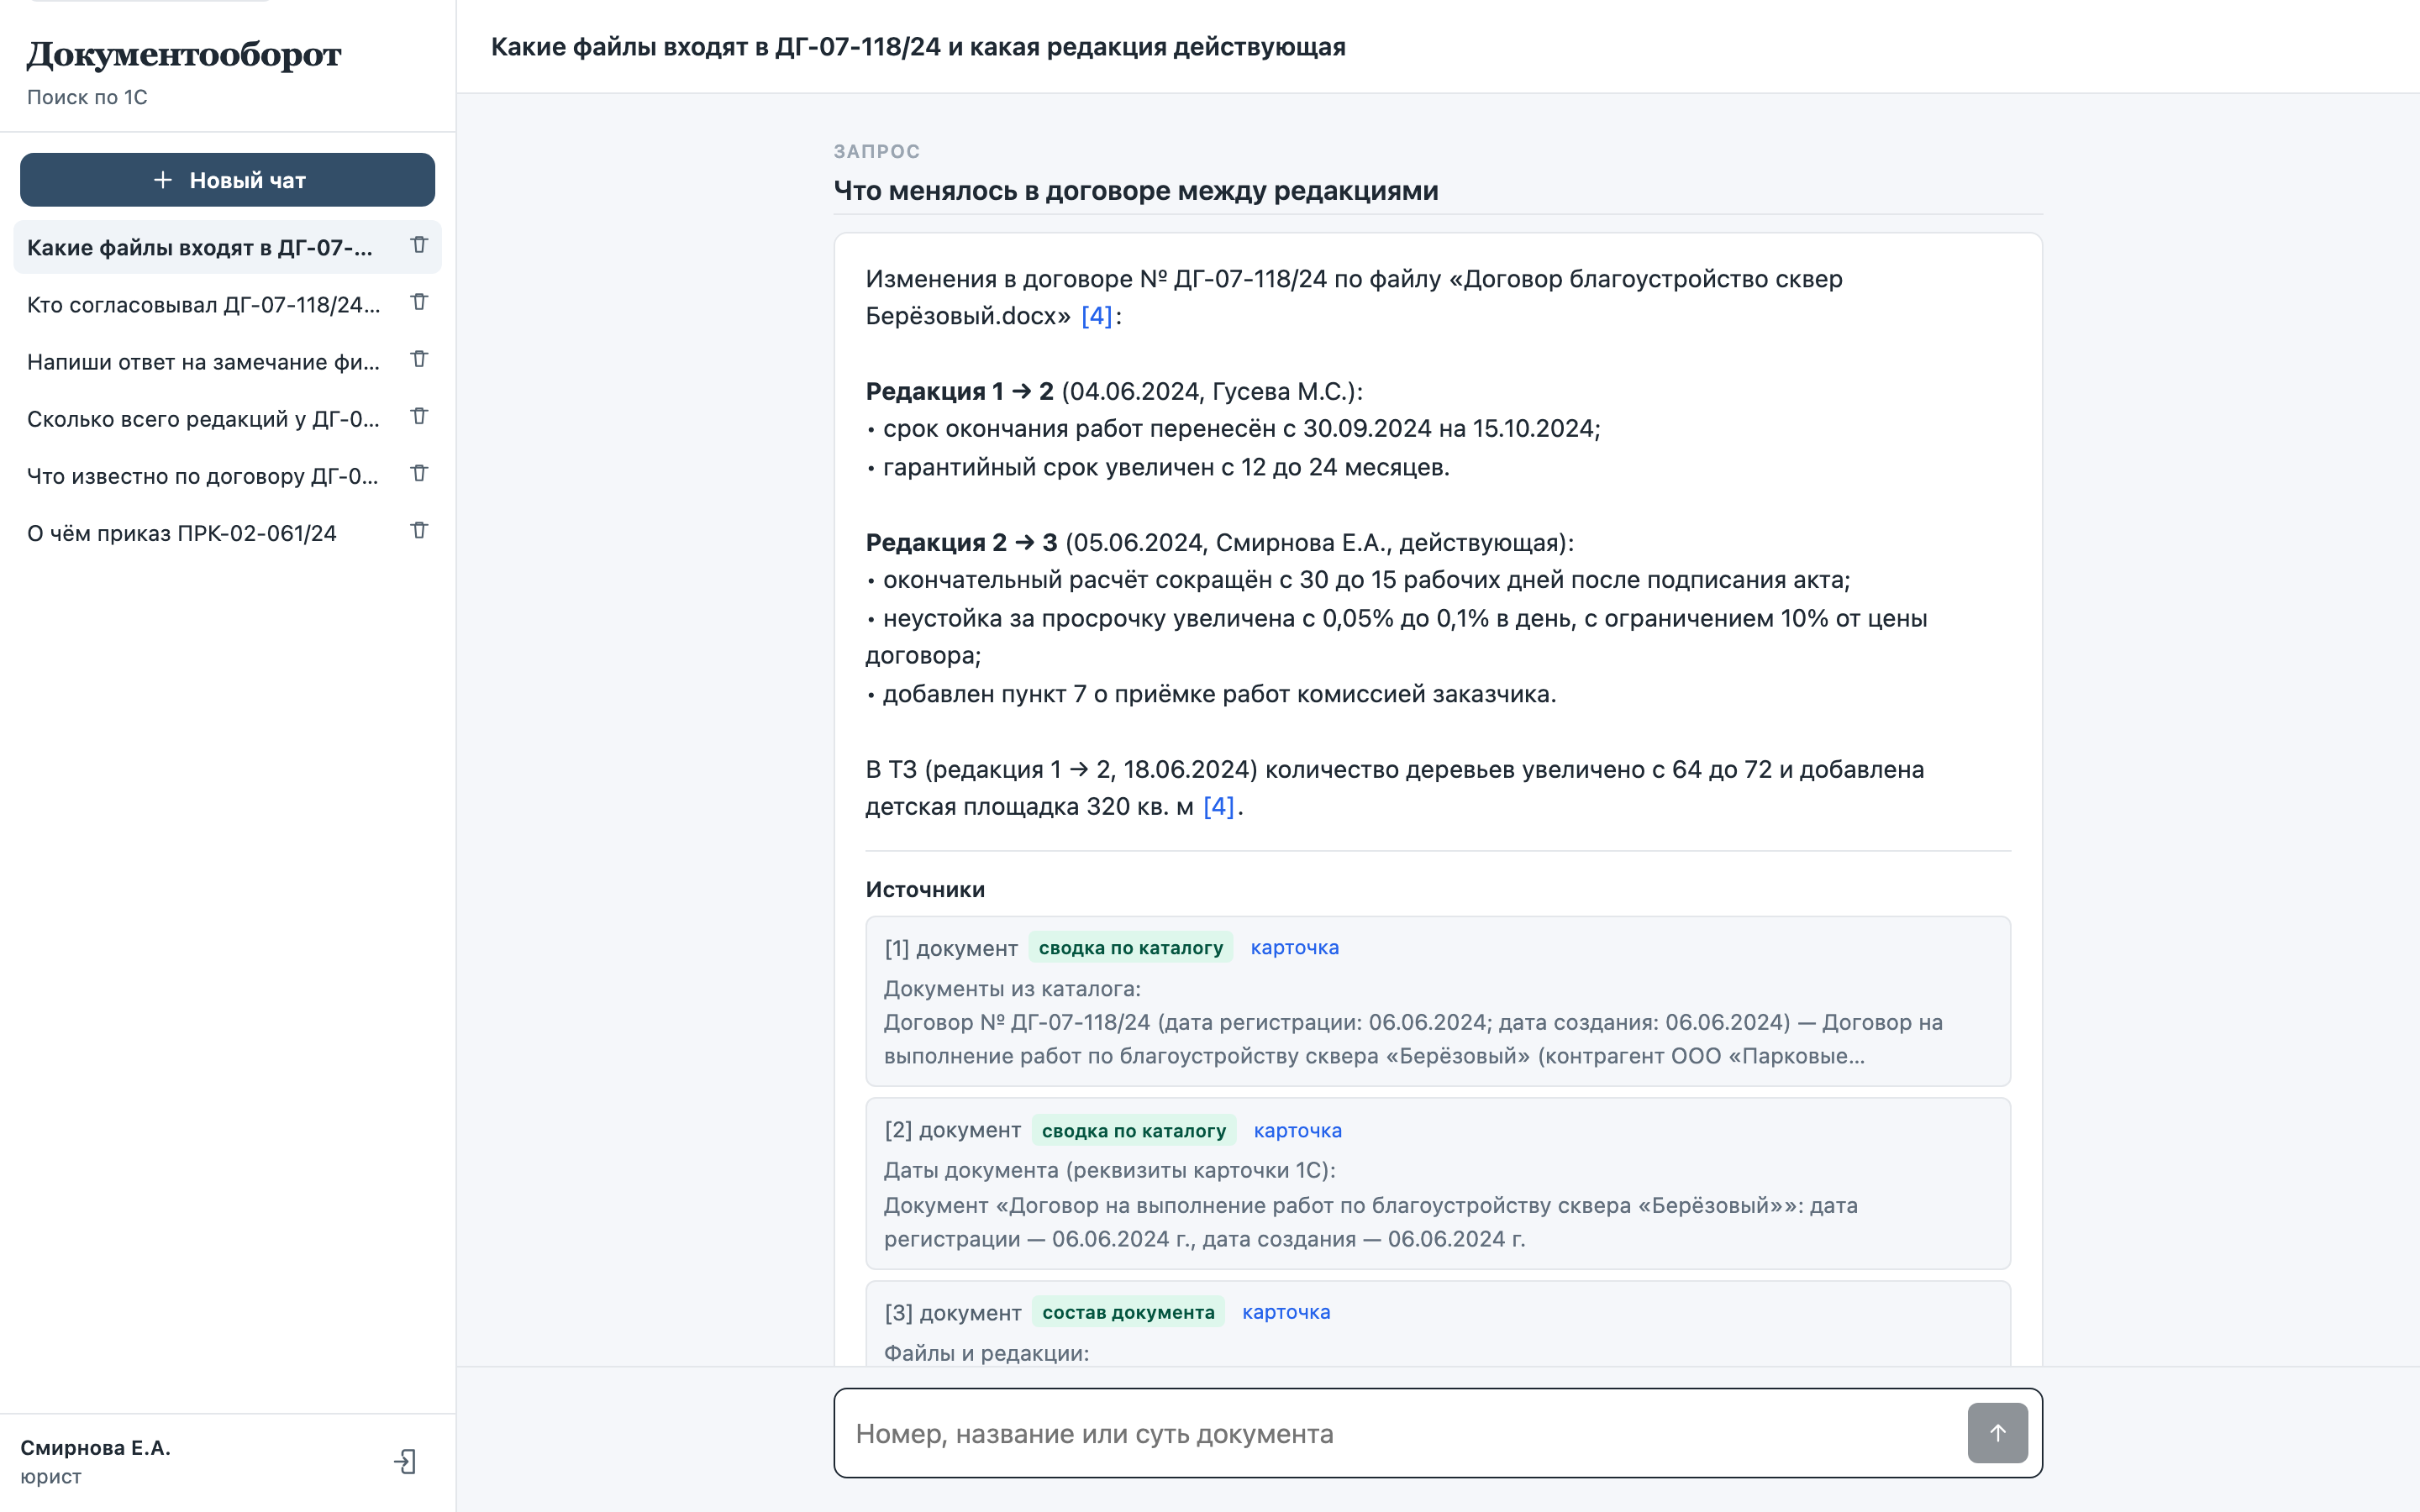
- Диффы соседних редакций по каждому файлу: на вопрос «что изменилось» ответ строится по сравнению текстов, а не по служебному комментарию
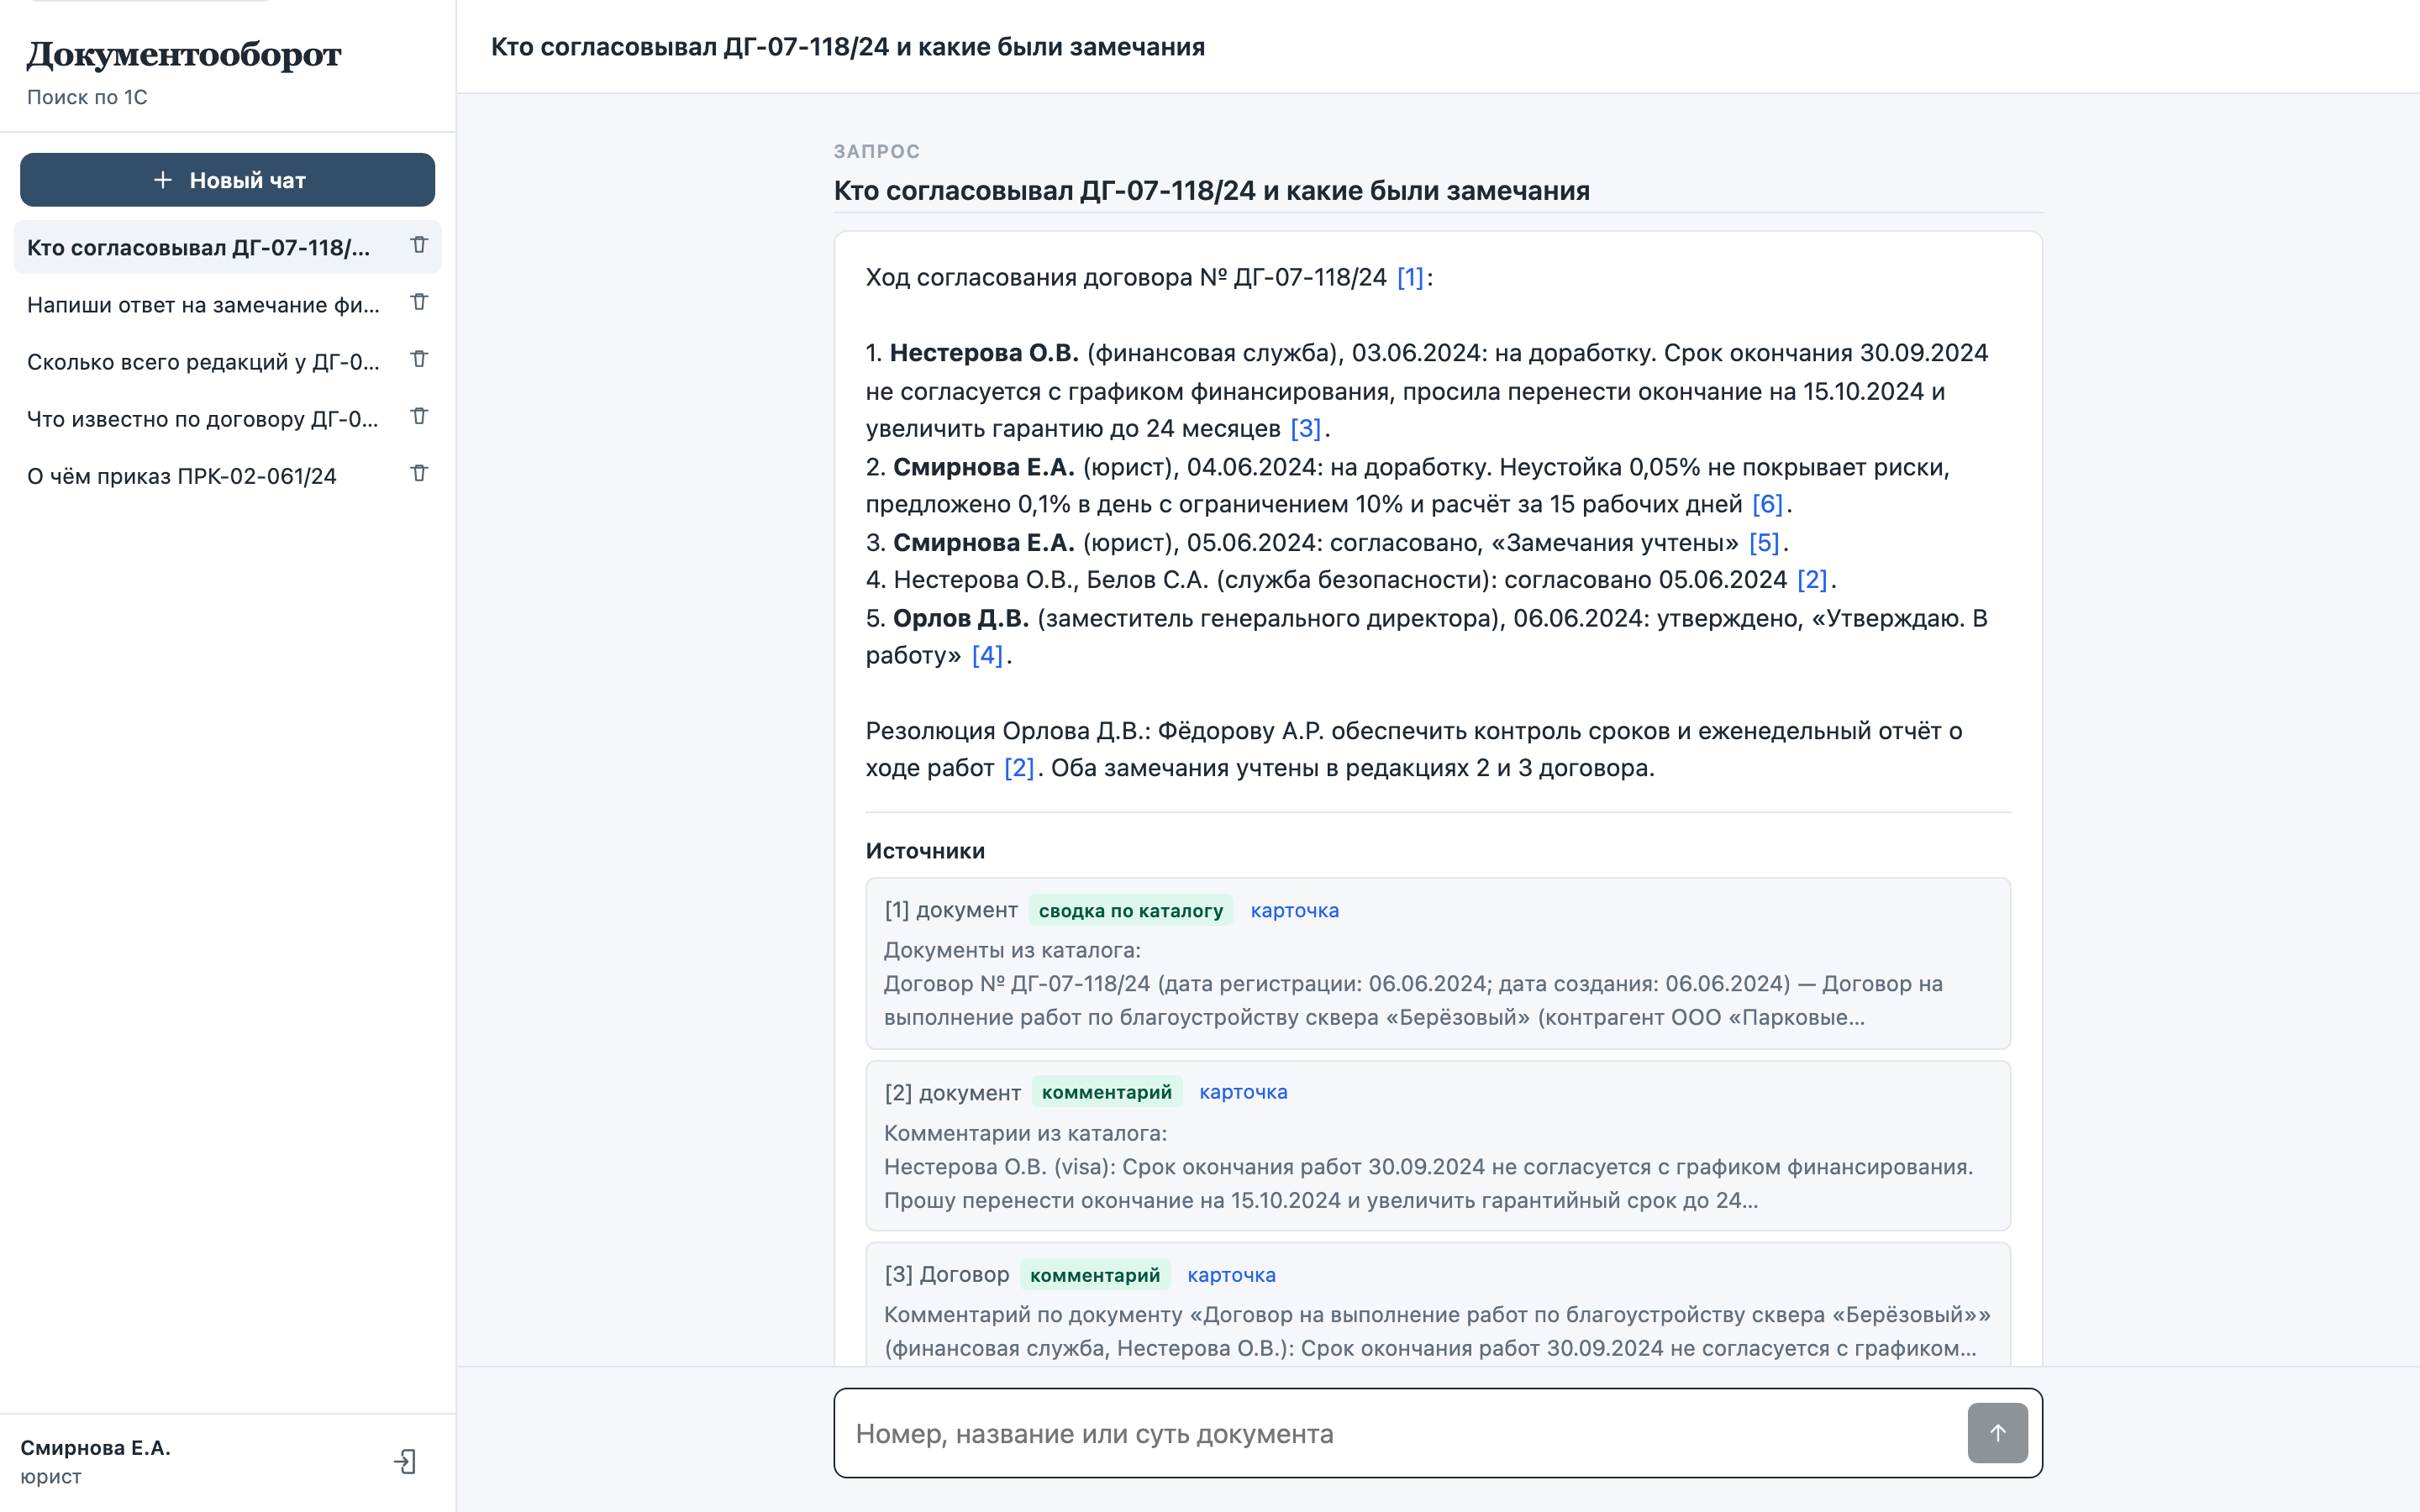
- Маршрут согласования: визы, 9 видов бизнес-процессов и задачи исполнителей превращаются в шаги, резолюции и результаты в истории документа
- Переписка: входящие и исходящие письма становятся документами каталога со связями «переписка» и «ответ на письмо»
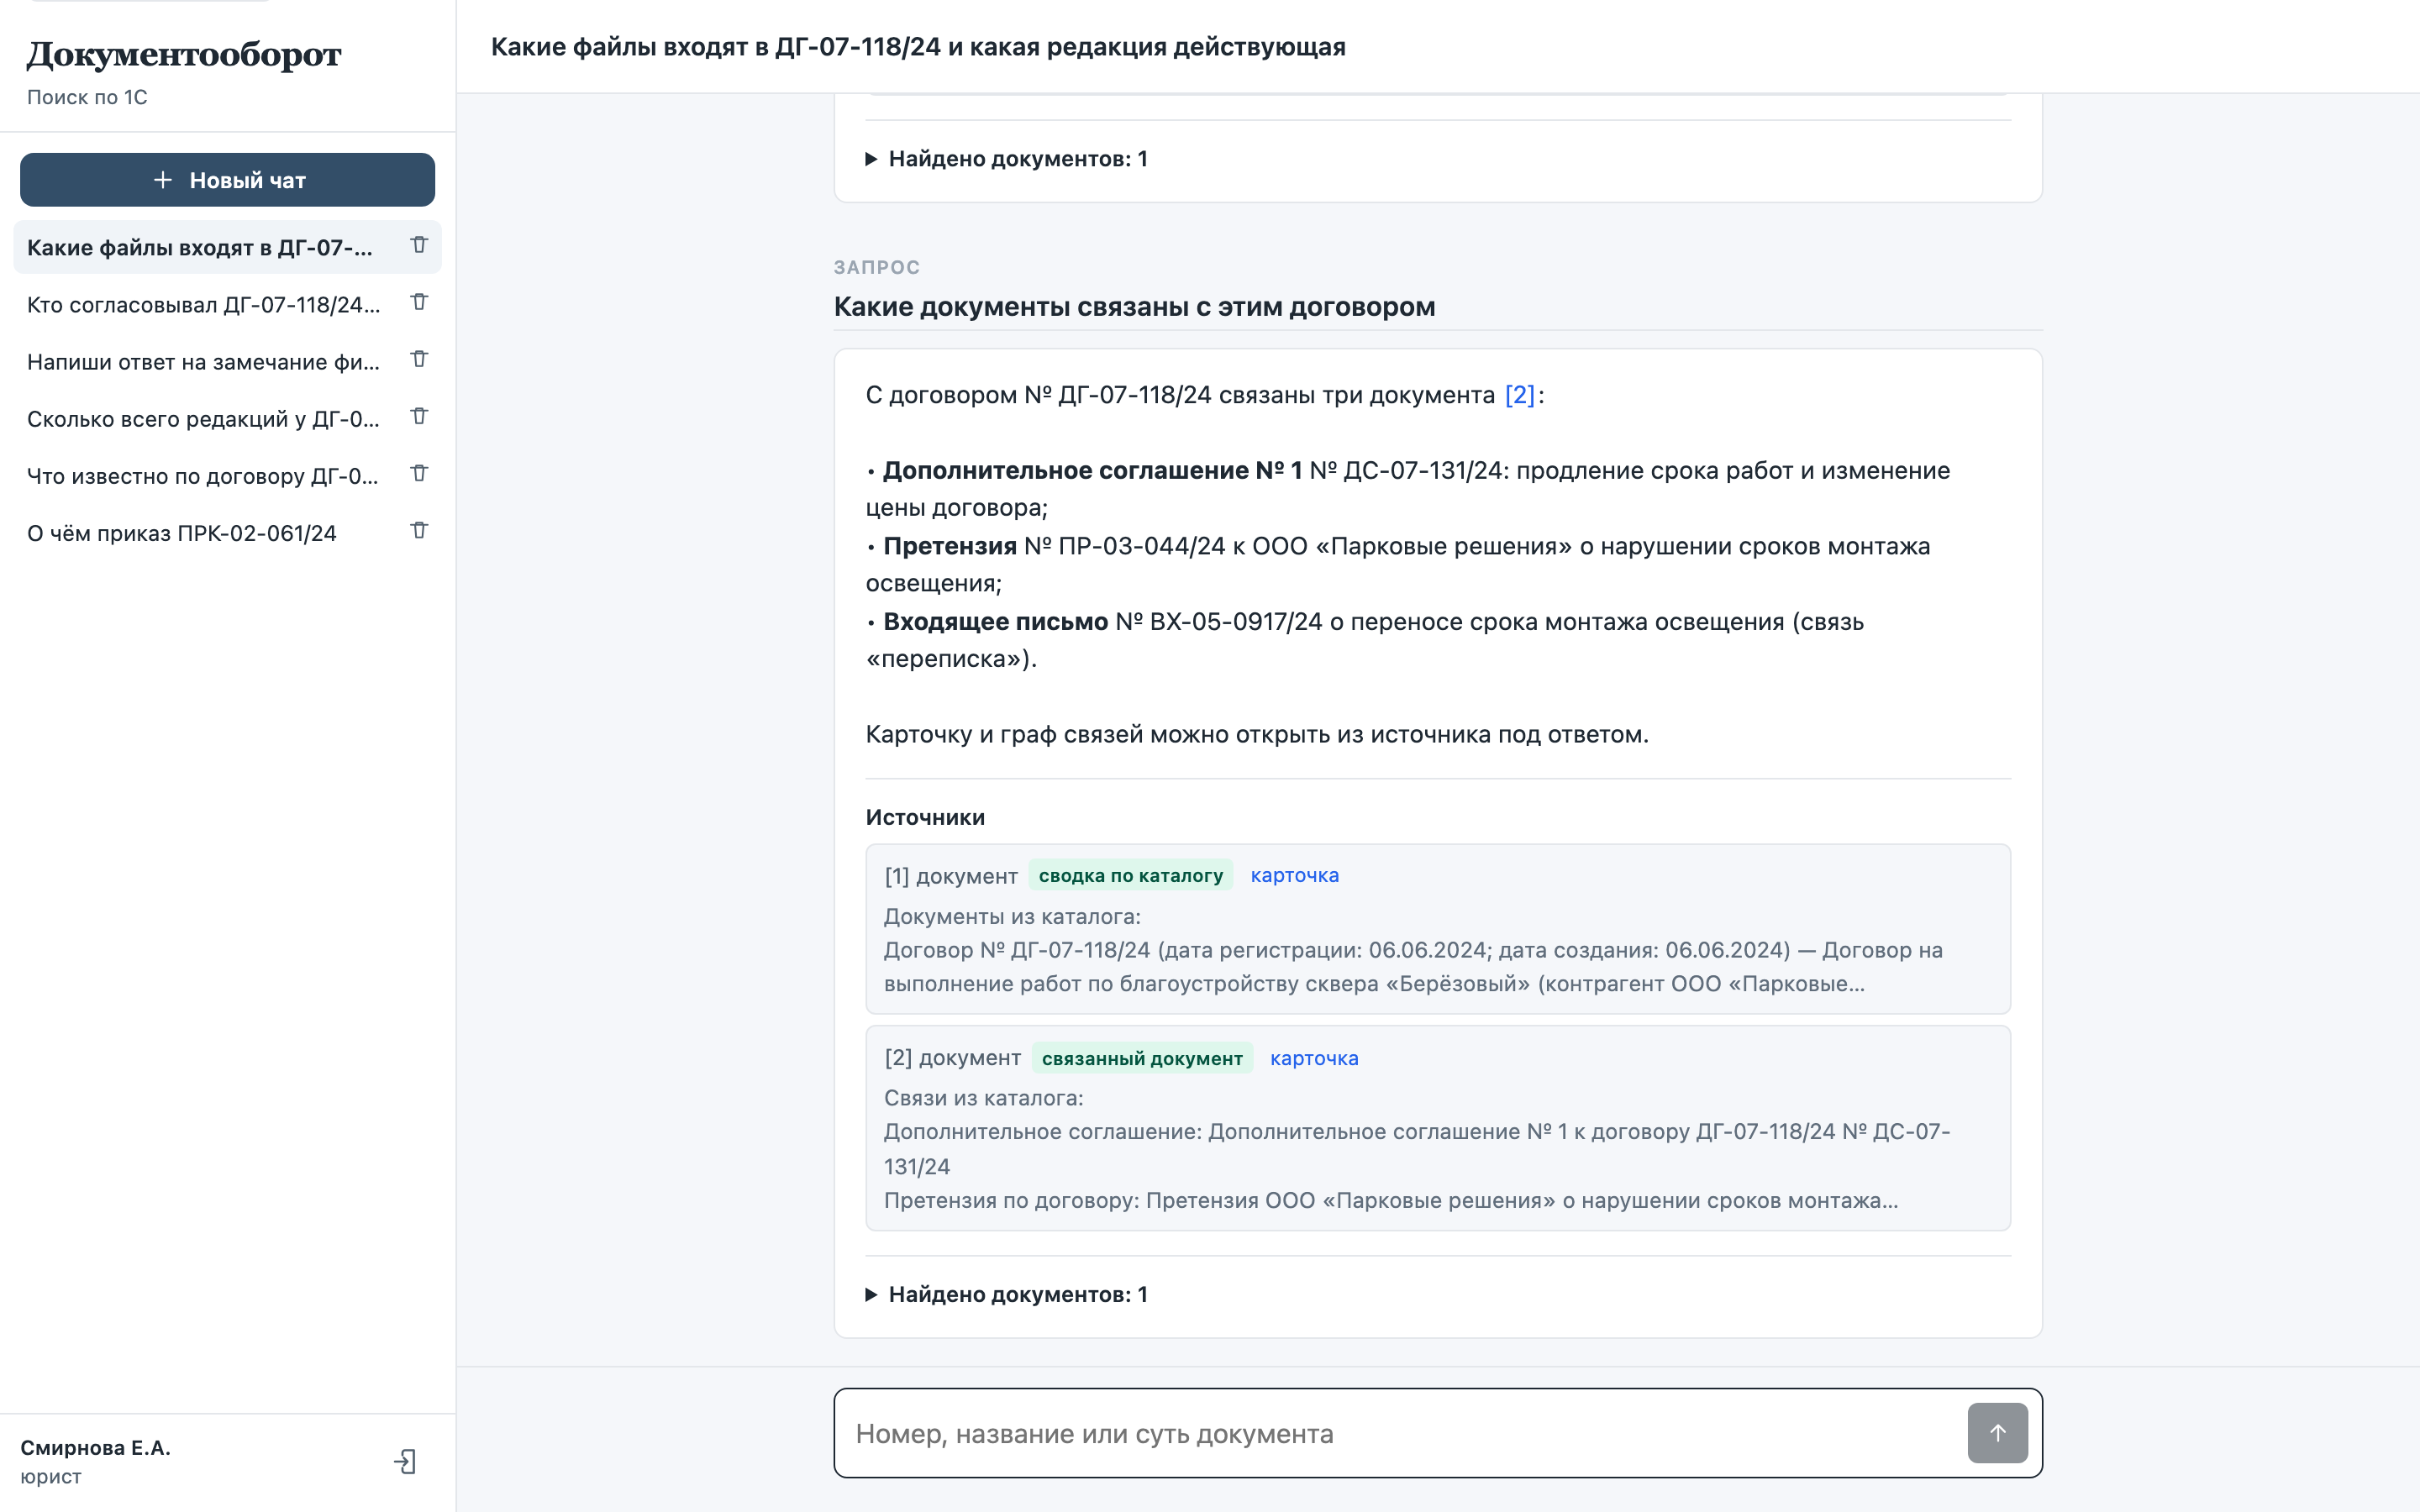
- Связи документов из регистра «СвязиОбъектов» с именем типа связи из 1С: в выдачу попадают доп. соглашения, претензии и акты к договору
- Переиндексация из каталога без обращения к 1С: пересборка поиска за полтора часа вместо одиннадцати часов полной выгрузки
- Индексация в Qdrant: dense-вектор bge-m3 и sparse-вектор BM25 у каждого фрагмента, payload-фильтры по виду документа, файлу, редакции и источнику
- Гибридный поиск: dense и BM25 в одном запросе, слияние RRF, reranking cross-encoder’ом jina-reranker-v2-base-multilingual
- Маршрутизатор источника данных: отдельный вызов LLM возвращает строгий JSON (postgres, qdrant, hybrid, clarify, none) и фильтры, а SQL строит код по белому списку полей
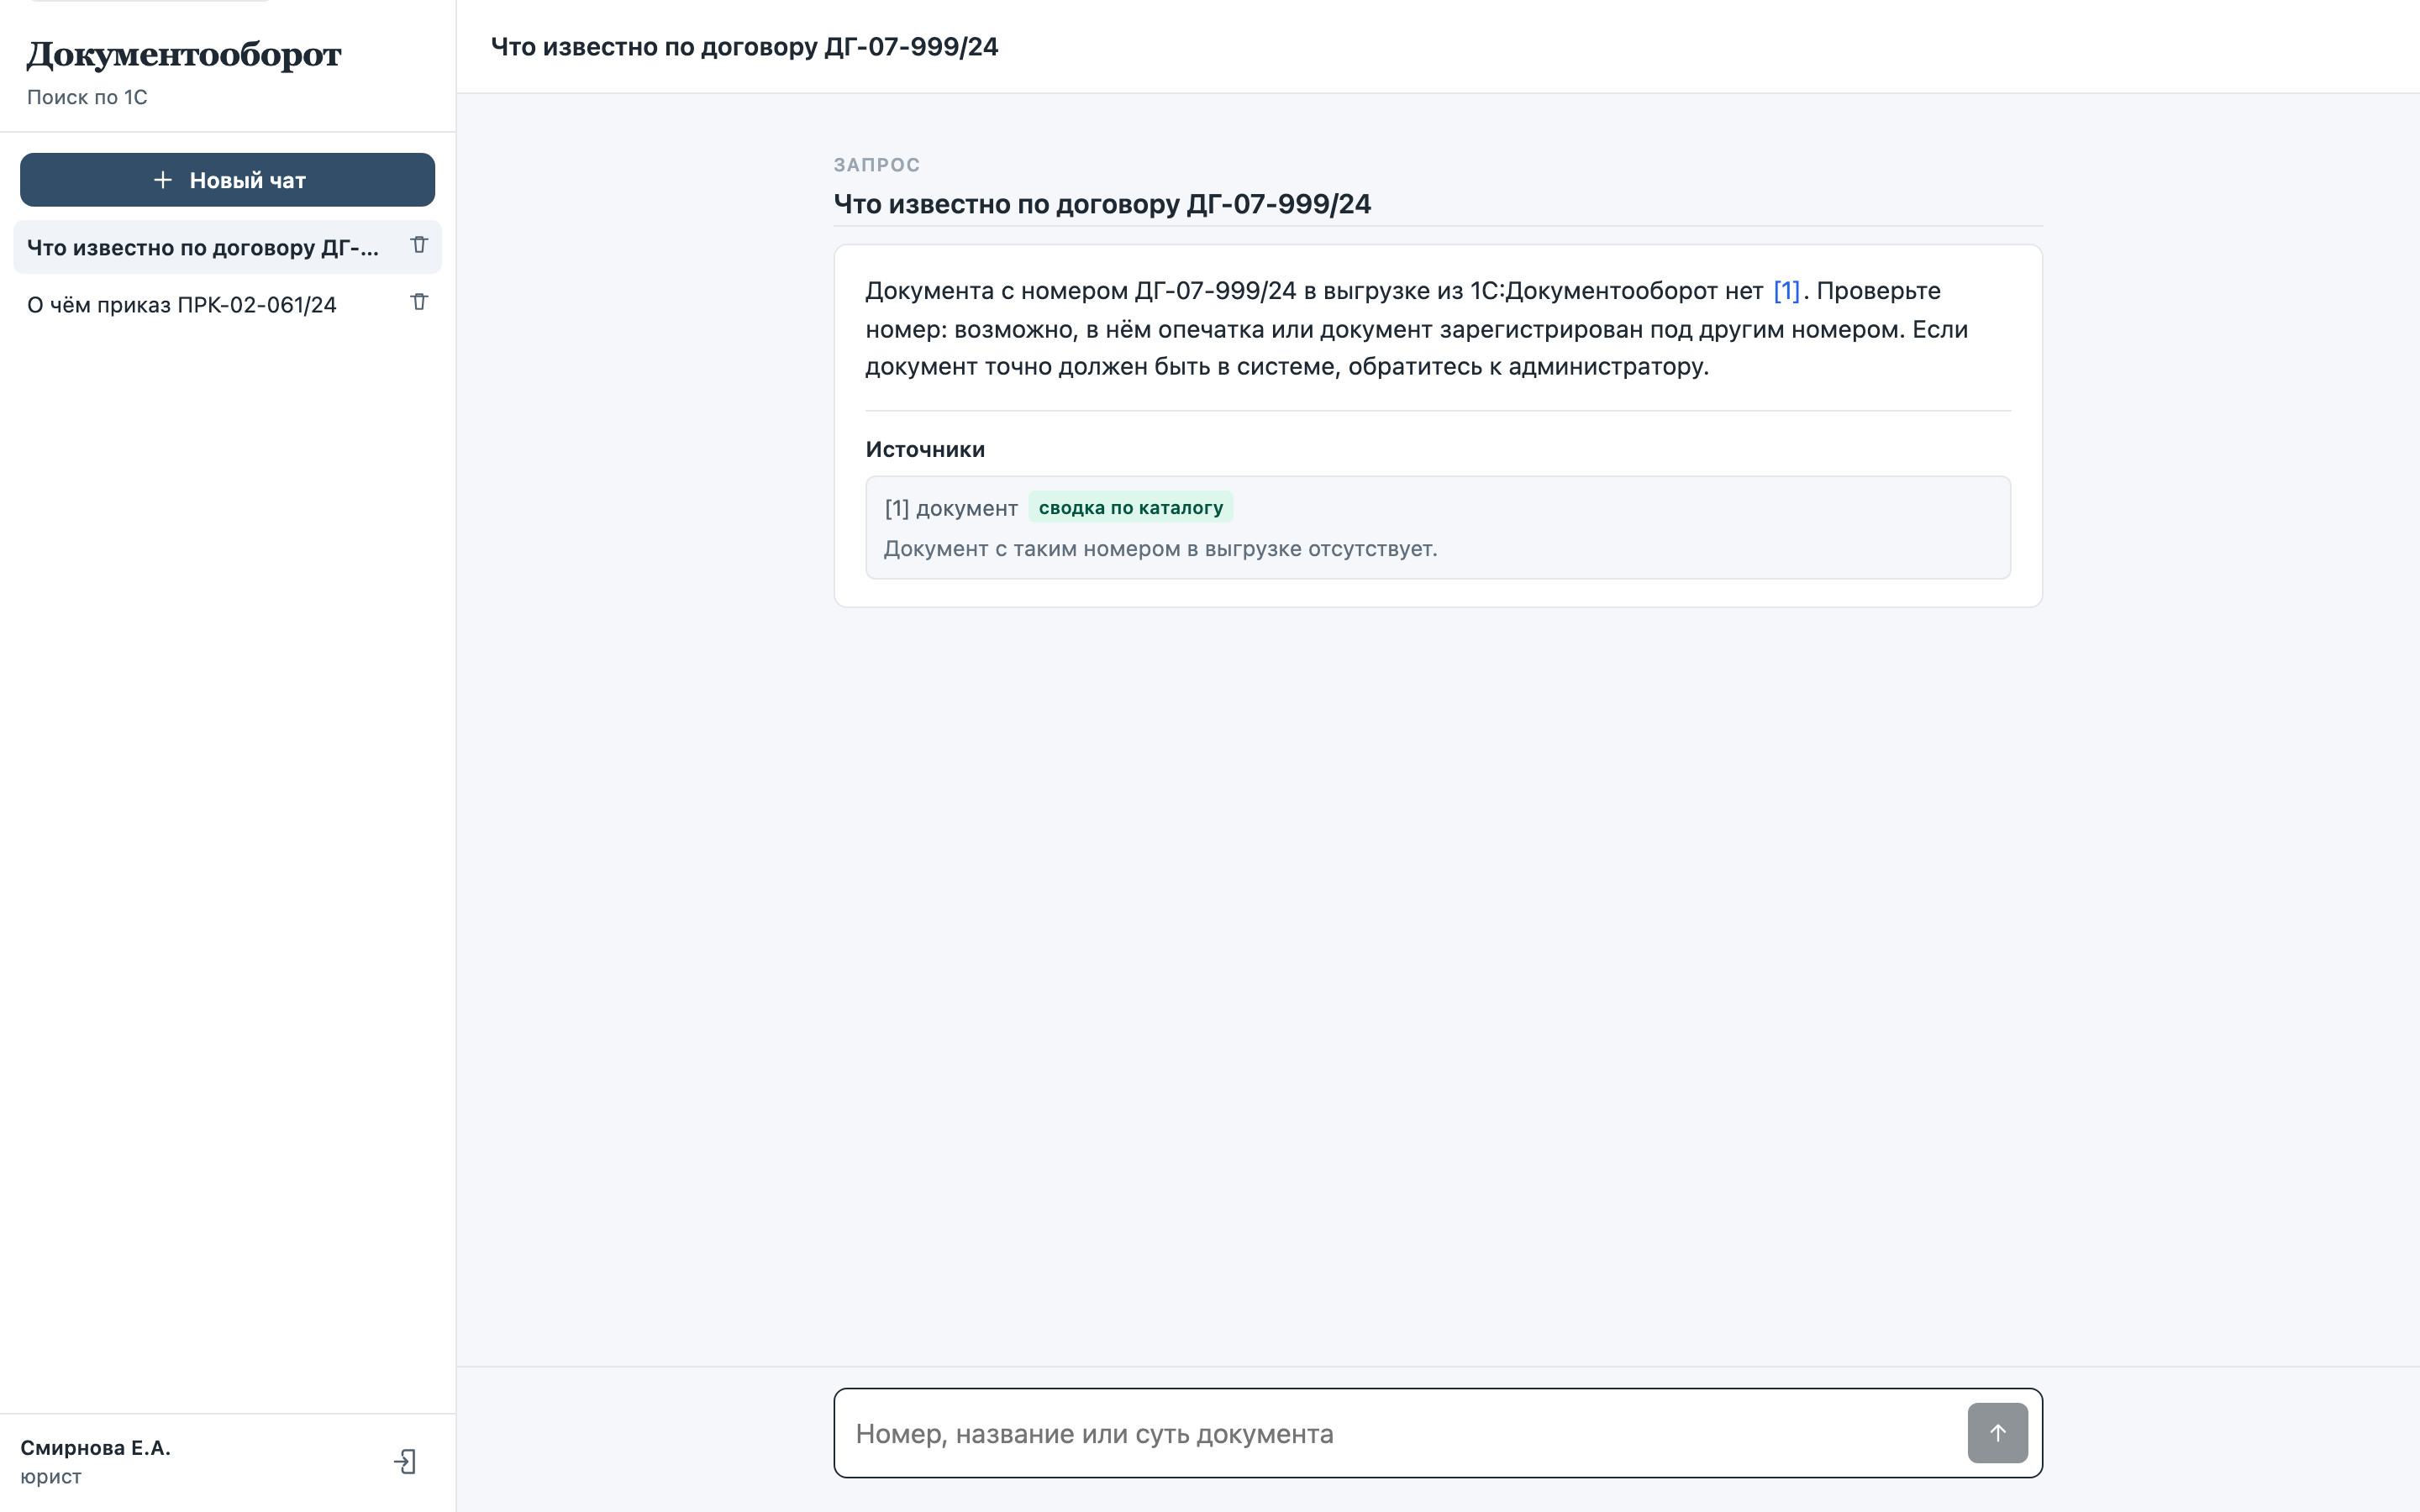
- Защита маршрутизатора: номера, имена и даты, которых нет в вопросе, отбрасываются; документ с номером всегда проверяется по каталогу
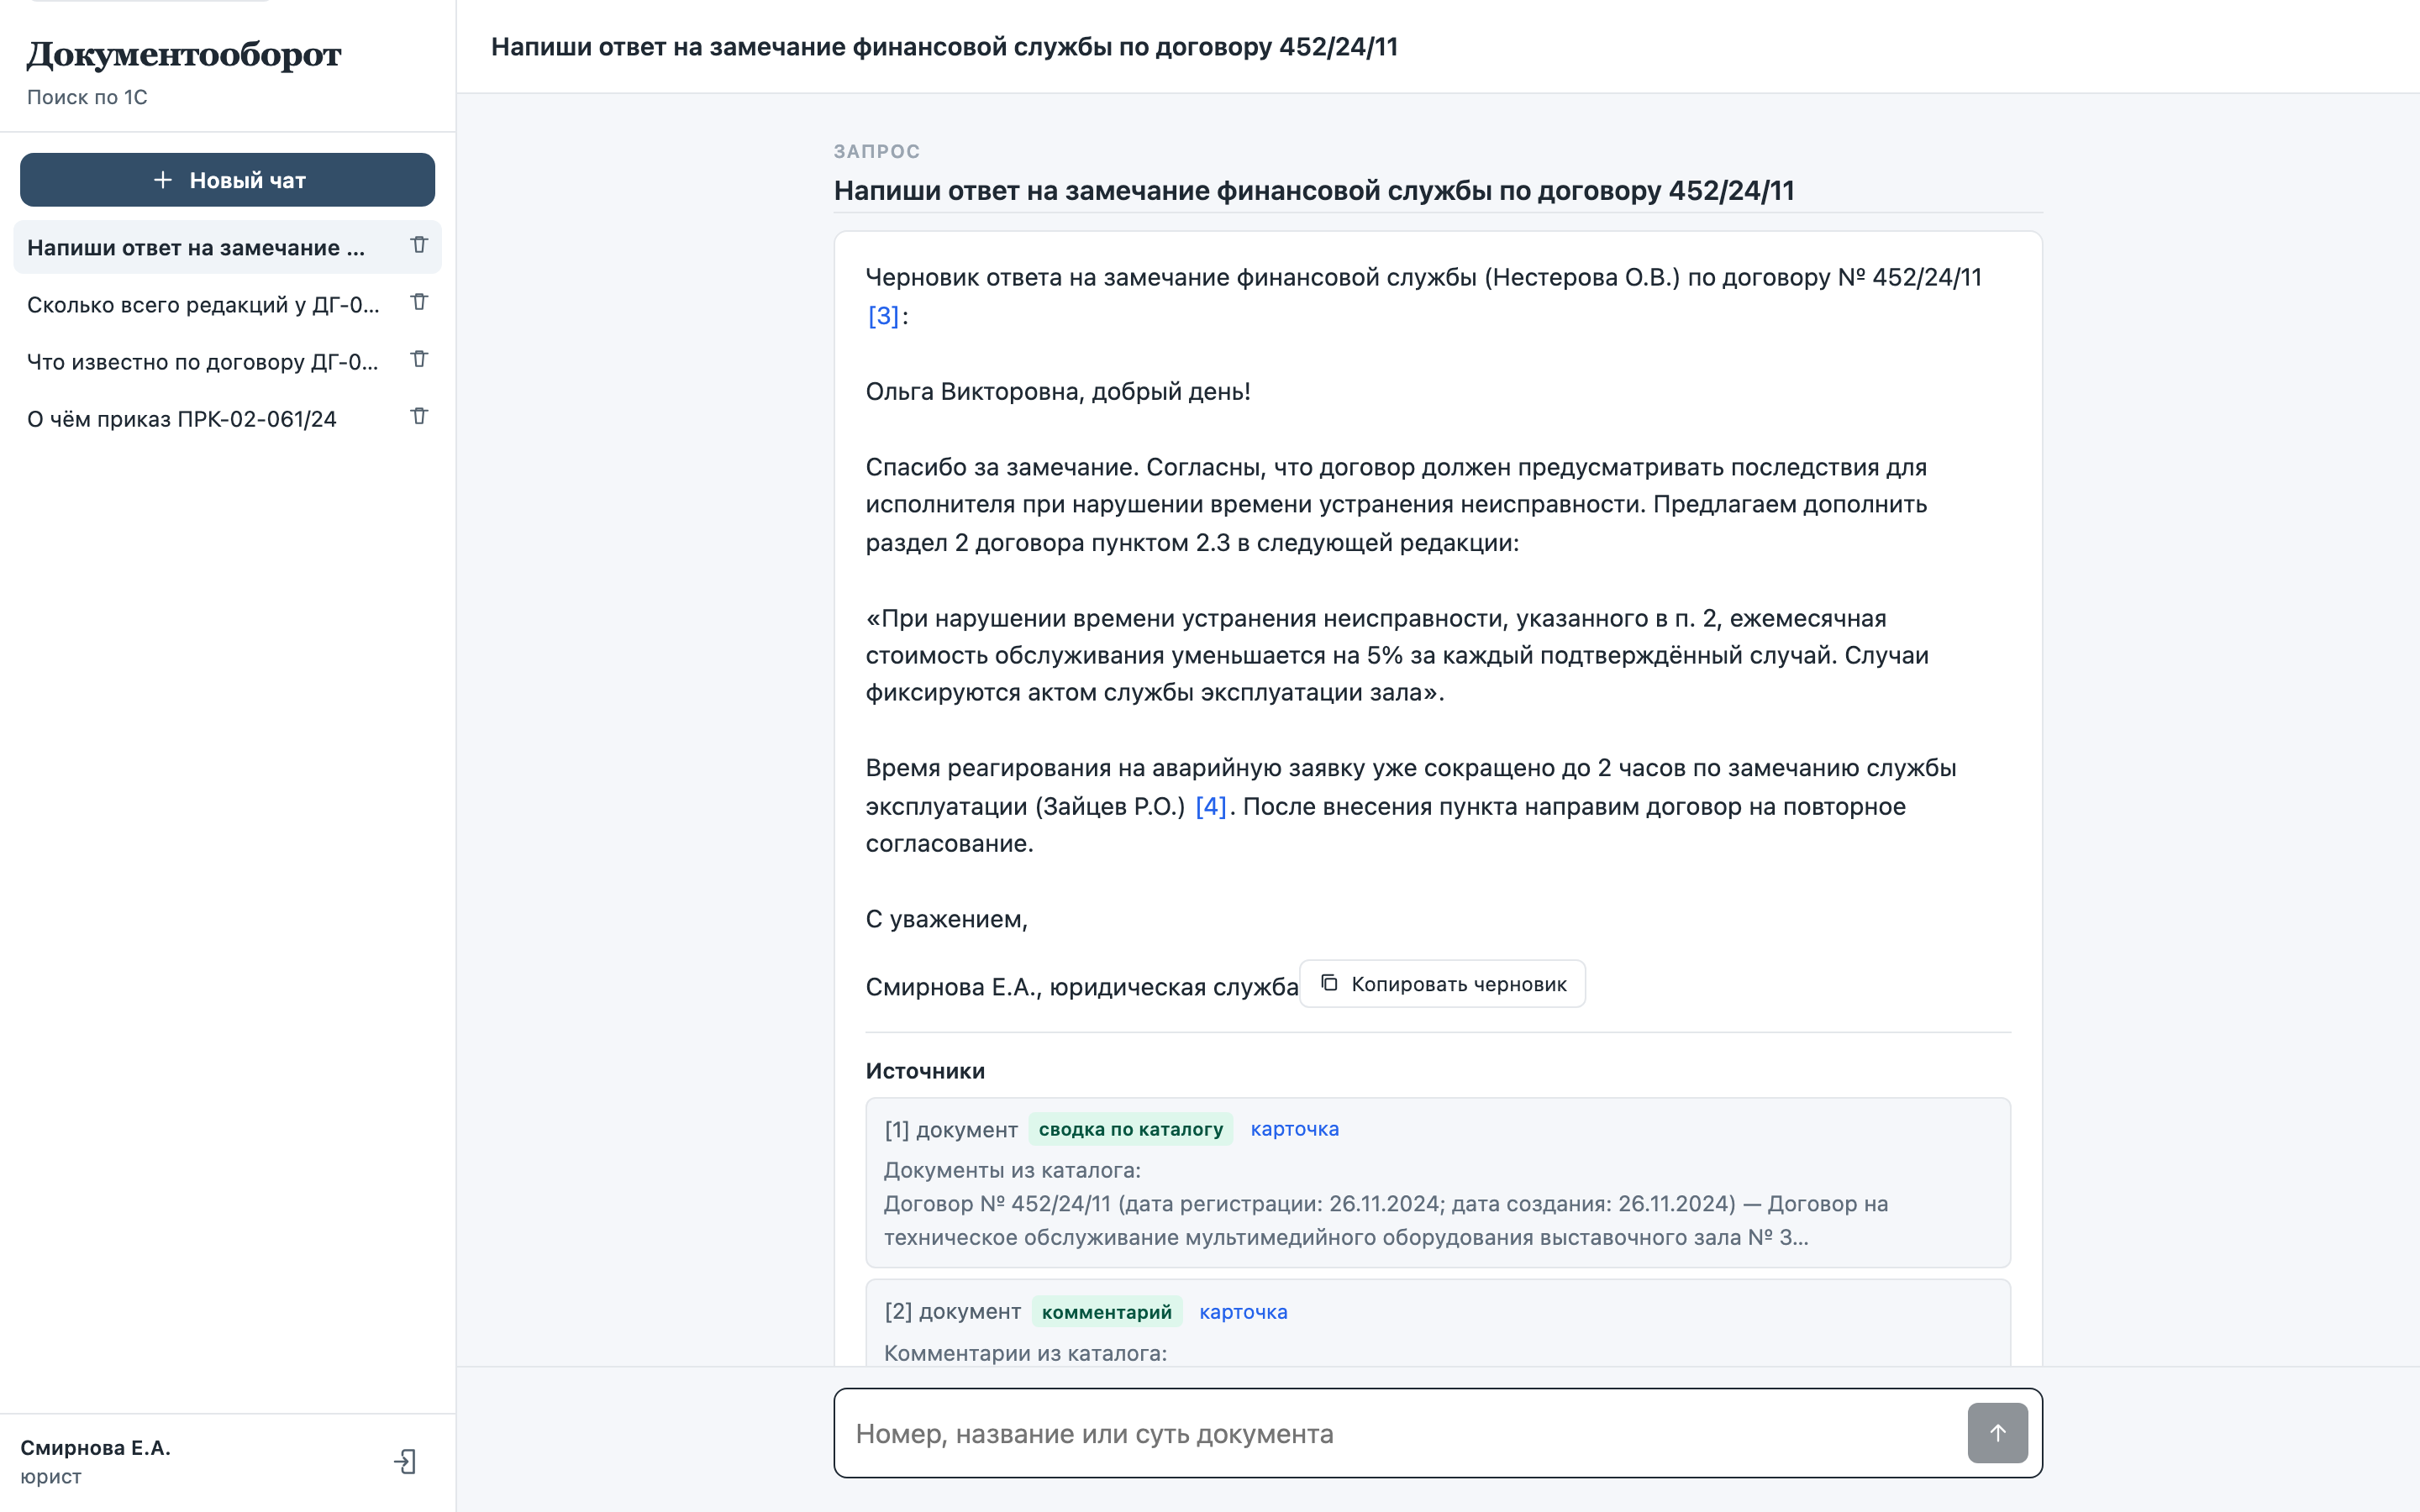
- Три сценария (документ и редакции, история согласования, черновик ответа на замечание) с автоопределением по тексту вопроса
- Диалоги на сервере: уточняющая реплика раскрывается в полный вопрос, номер карточки держится в контексте чата
- Очередь вопросов: в одном чате вопросы идут по порядку и дочитываются без открытой вкладки, разные чаты считаются параллельно
- Инструменты расчёта для модели (calculate, days_between): суммы, разницы и сроки между датами в ответе считает Python, а не LLM
- Проверки после генерации: перевод при уходе модели в иероглифы, повтор при ложном отказе, запасной ответ перечнем источников
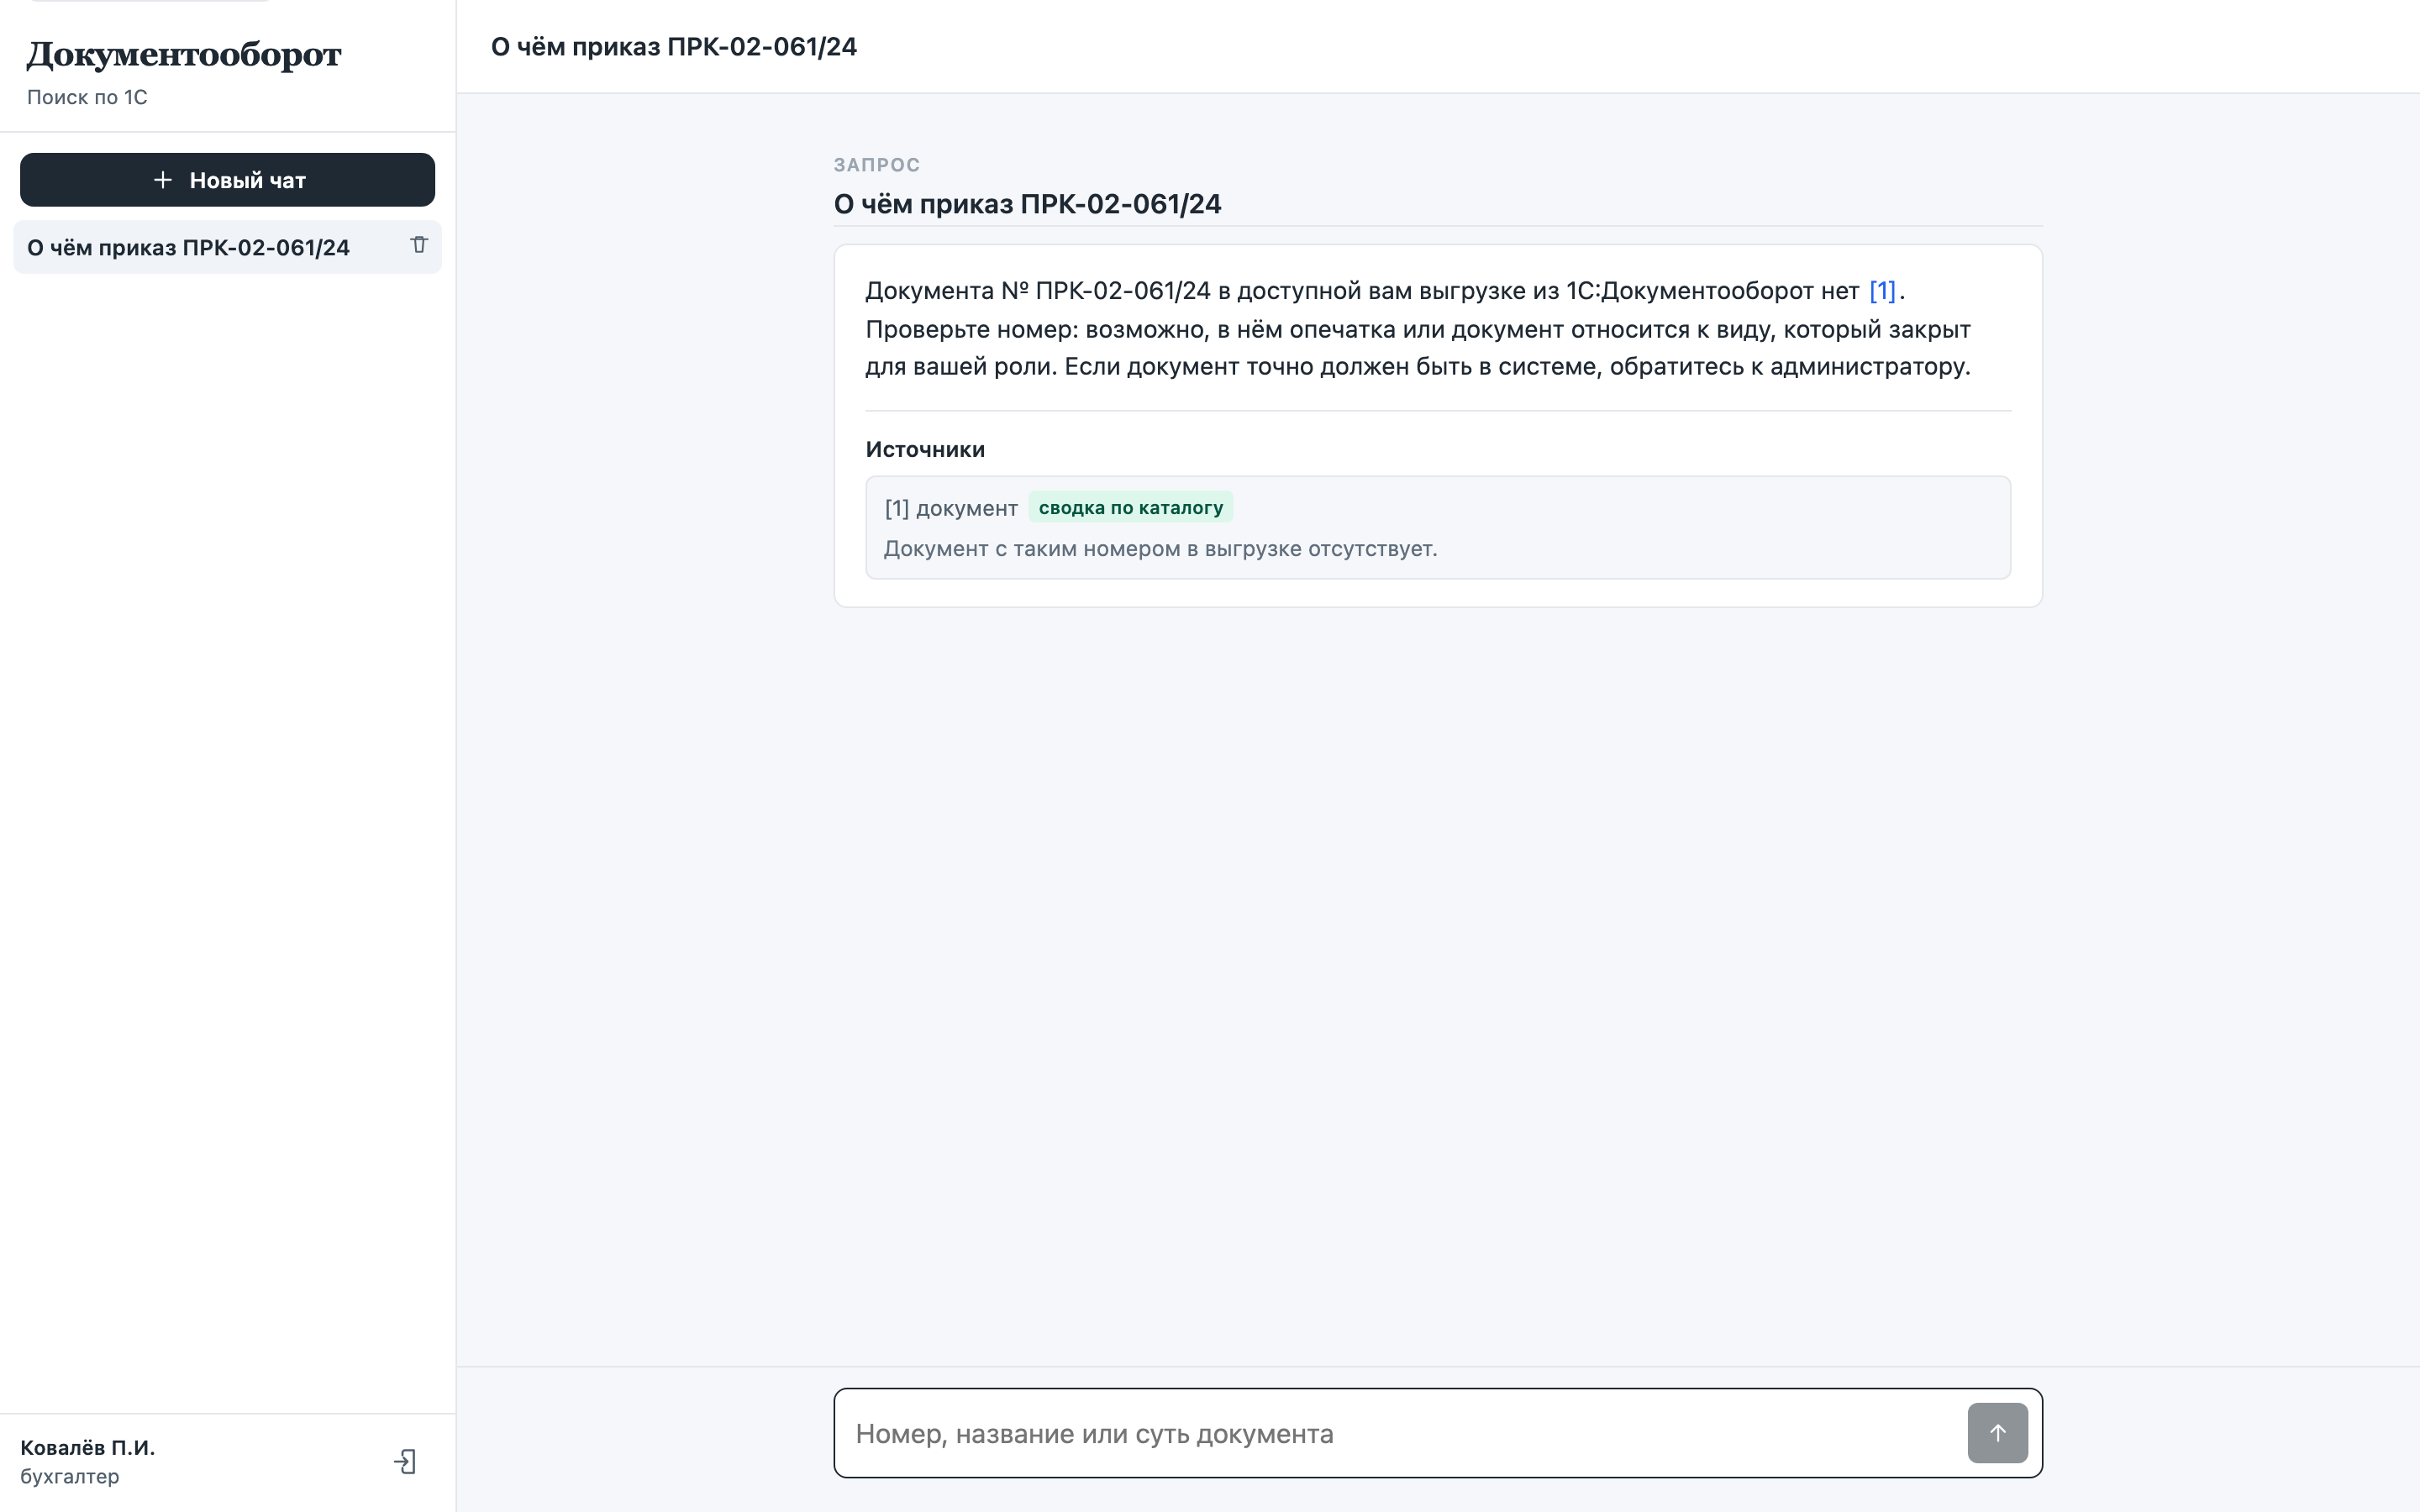
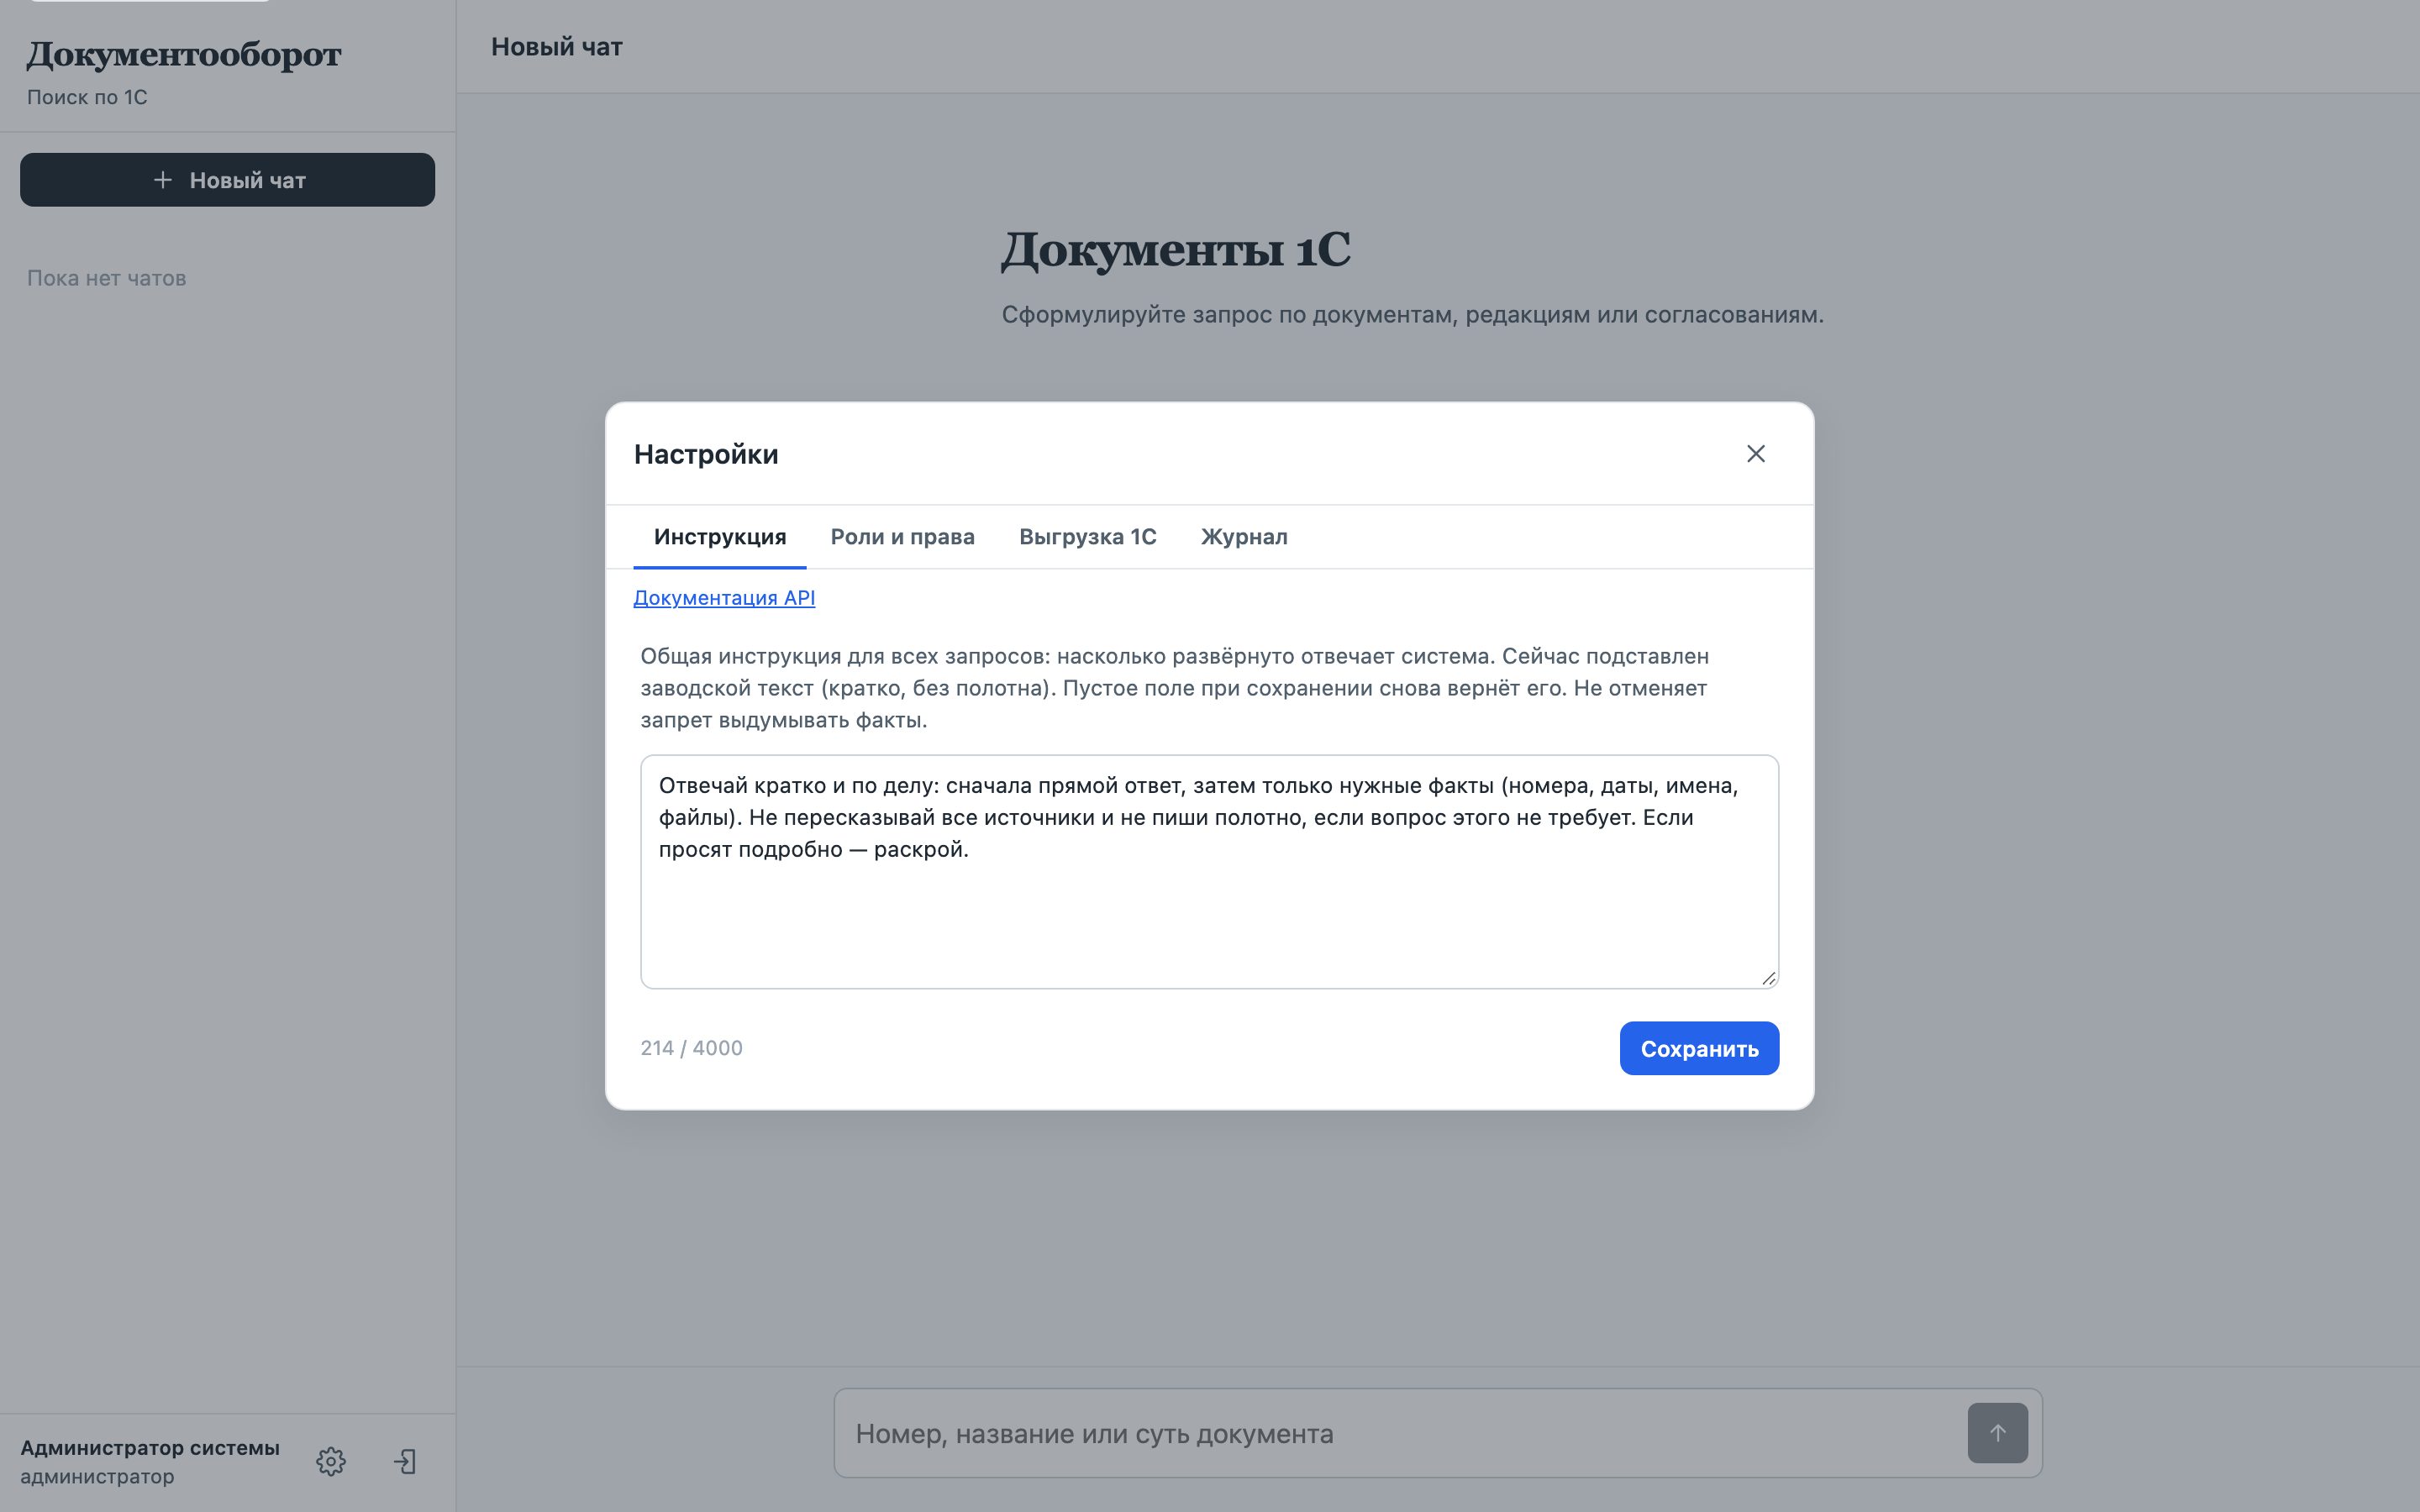
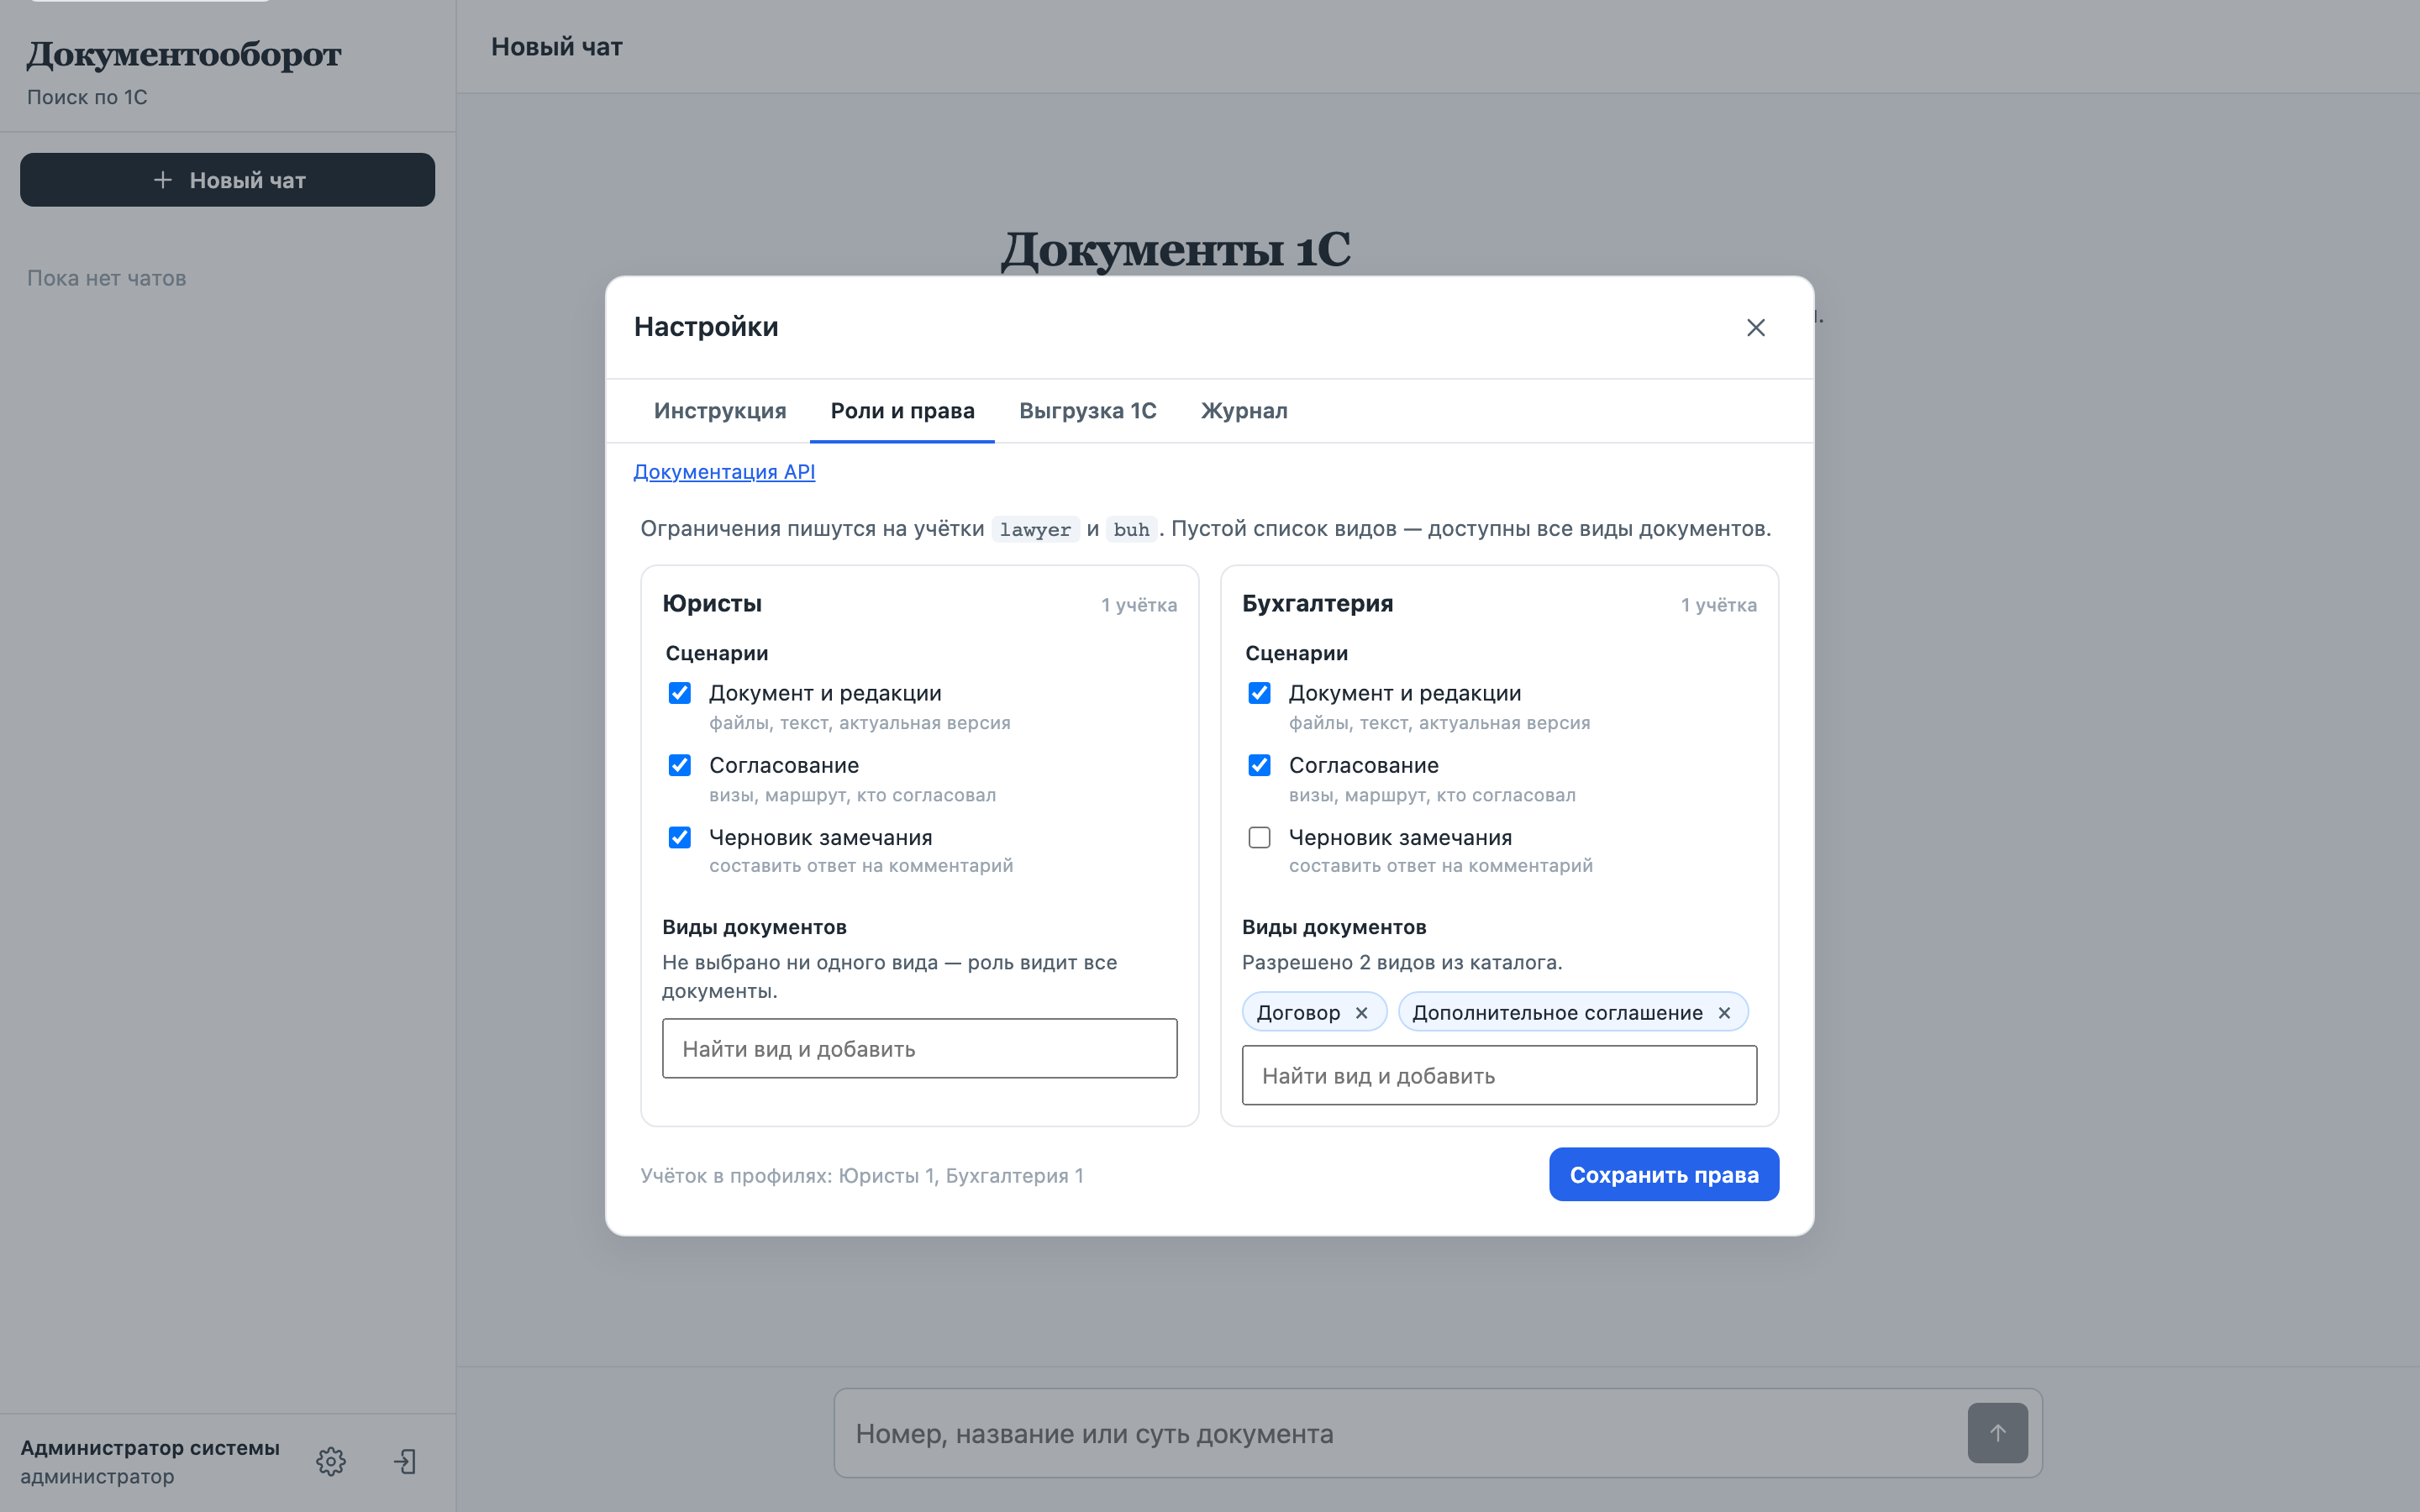
- Роли и права: сценарии и виды документов задаются ролям из админки, фильтр работает в поиске, карточке, графе и по прямой ссылке
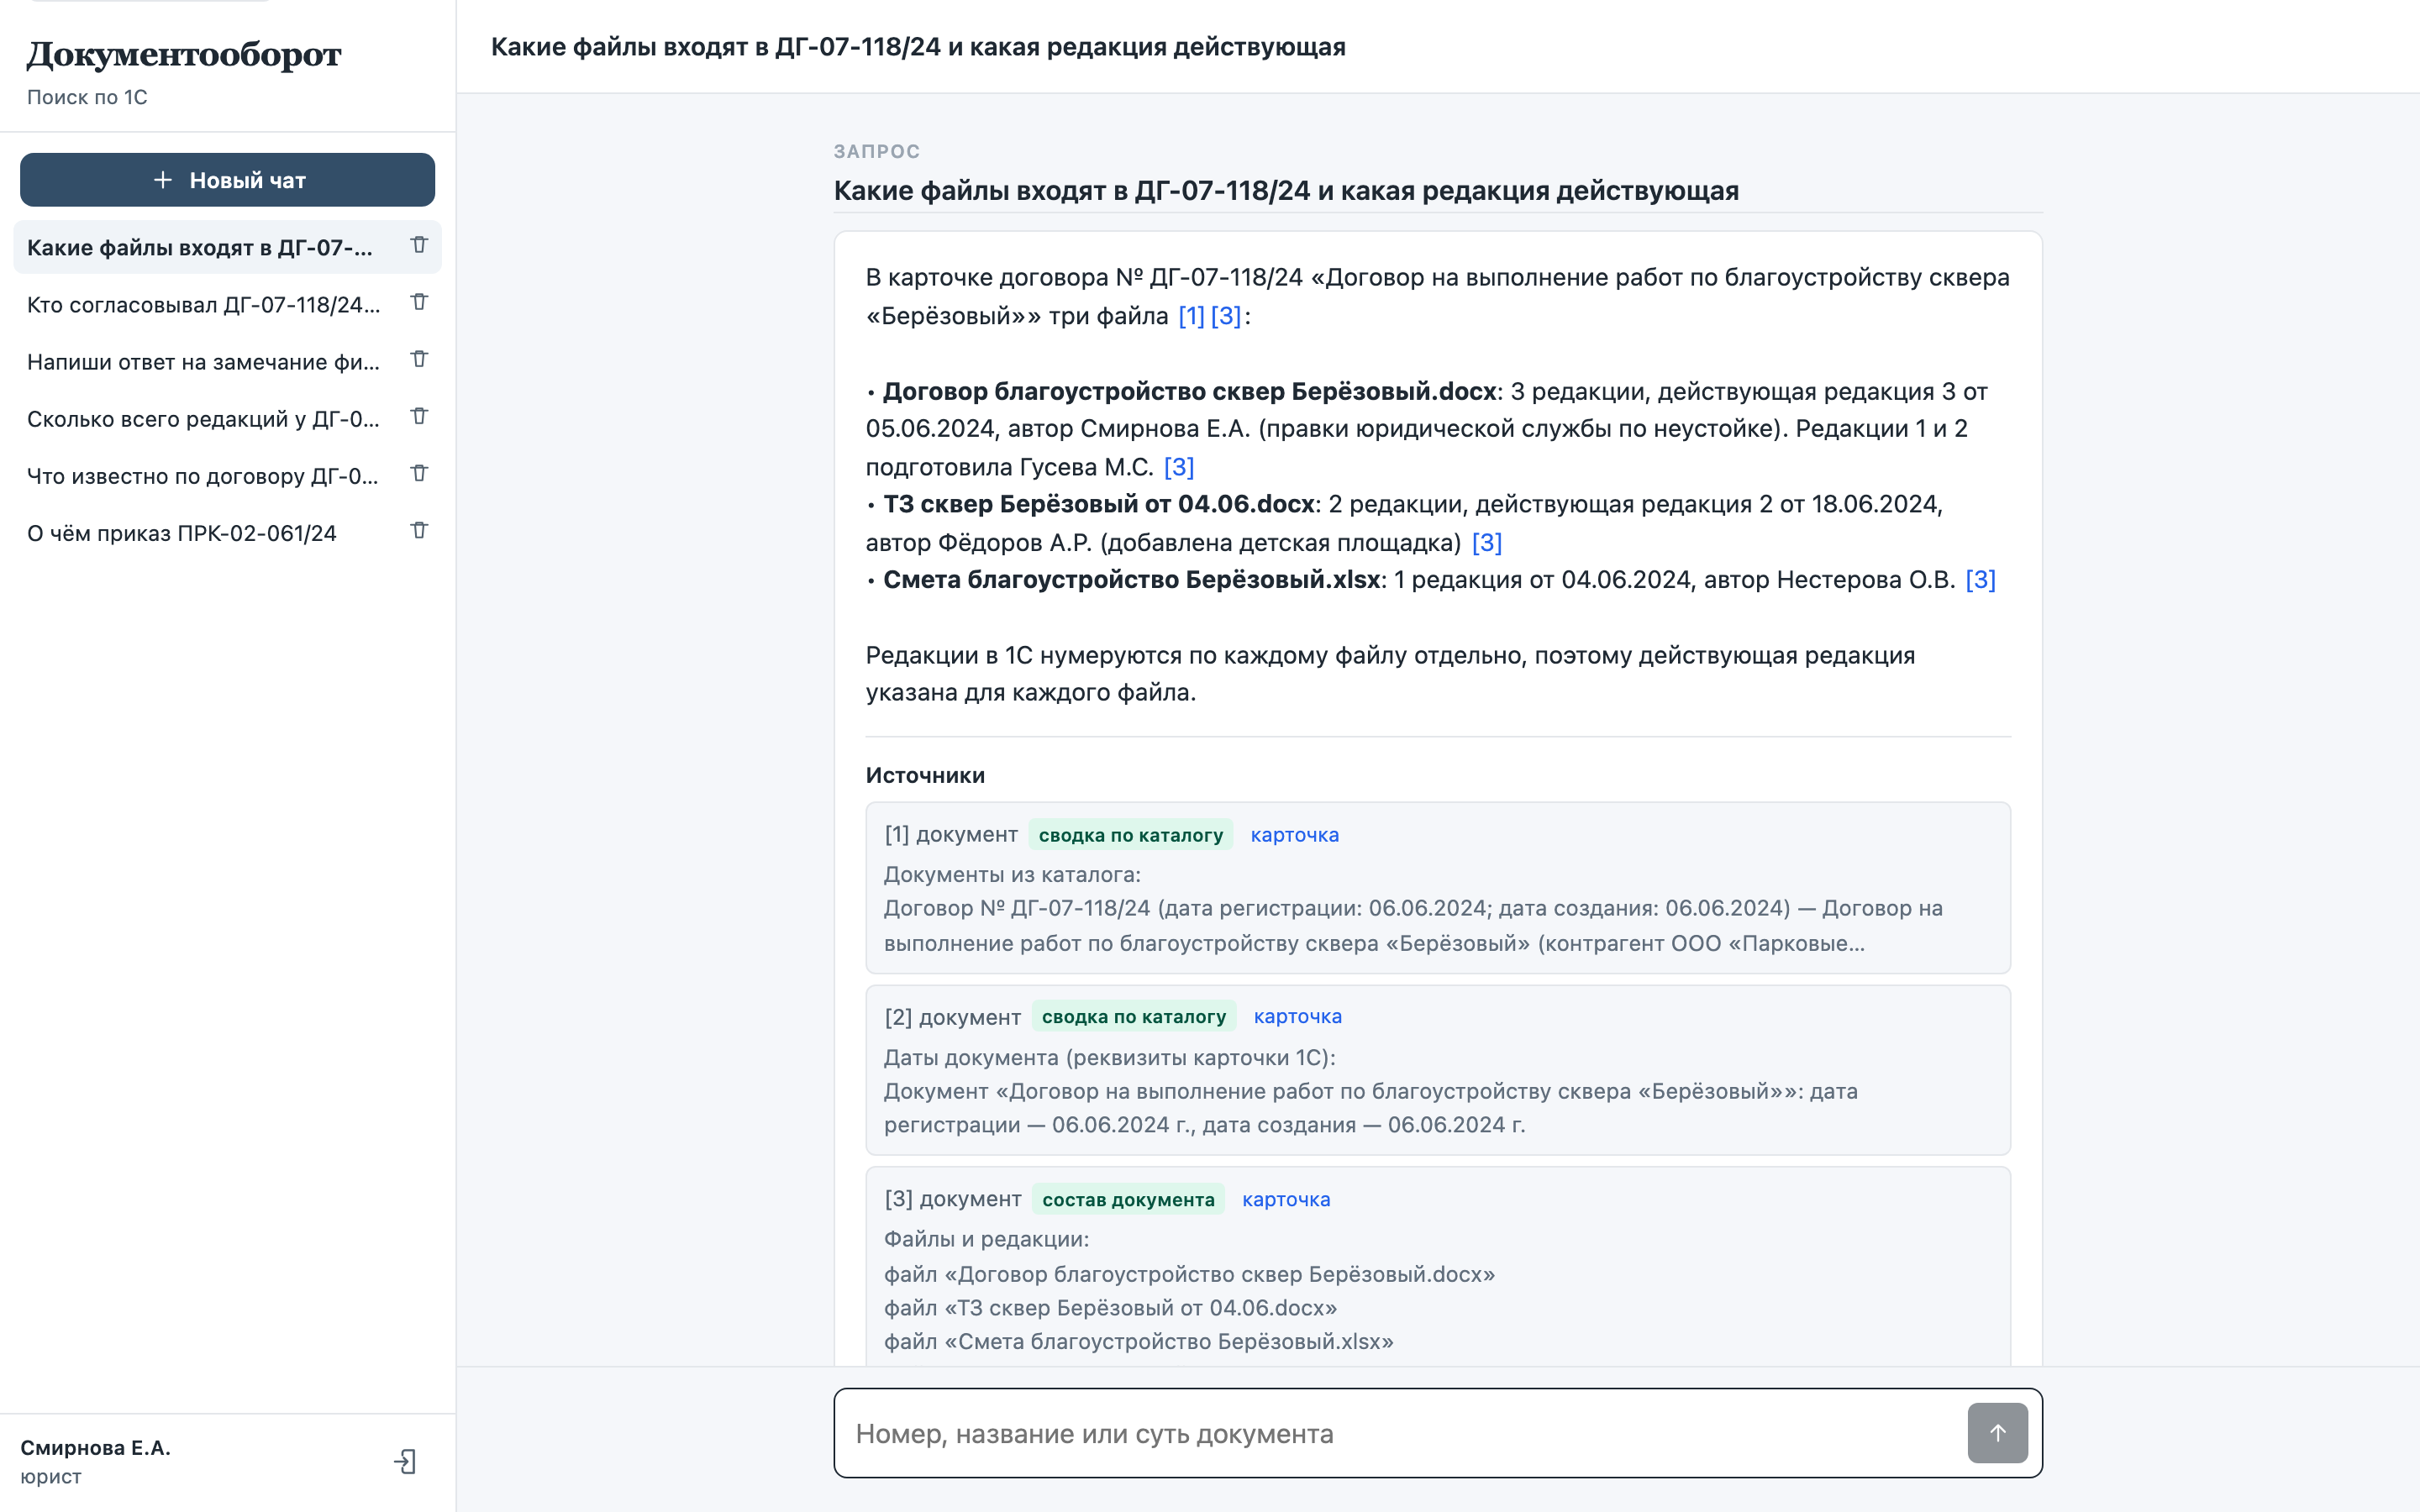
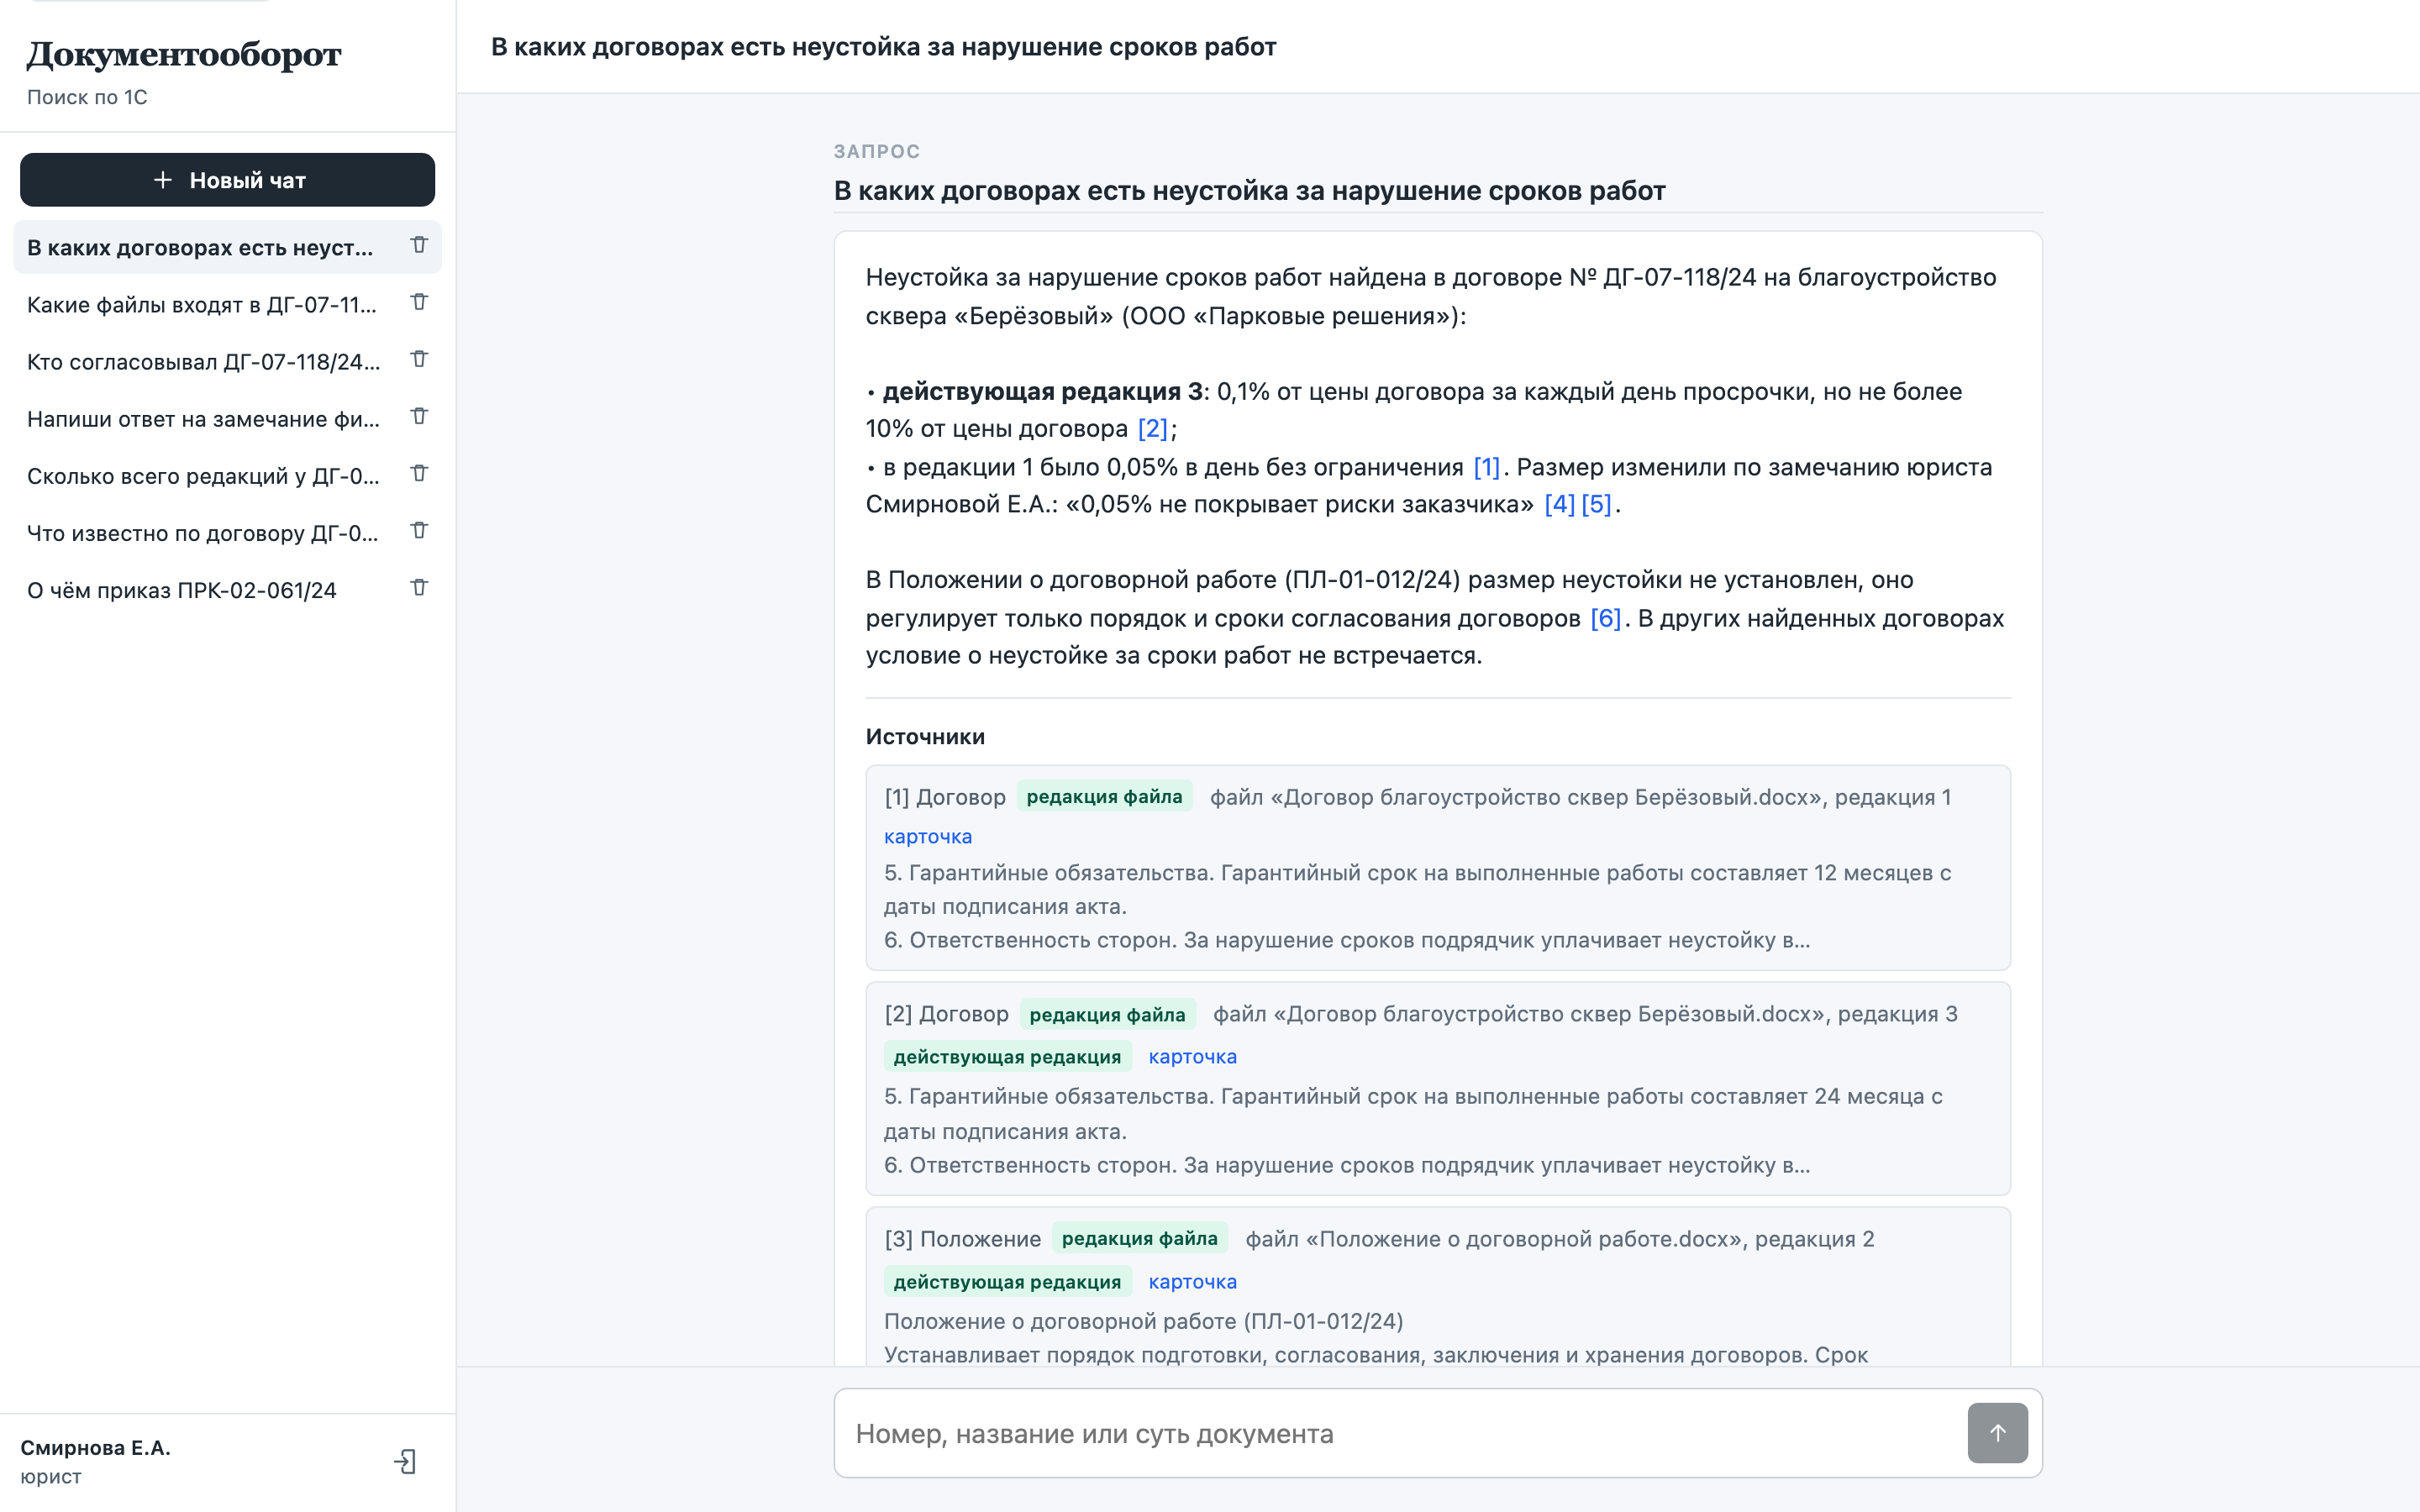
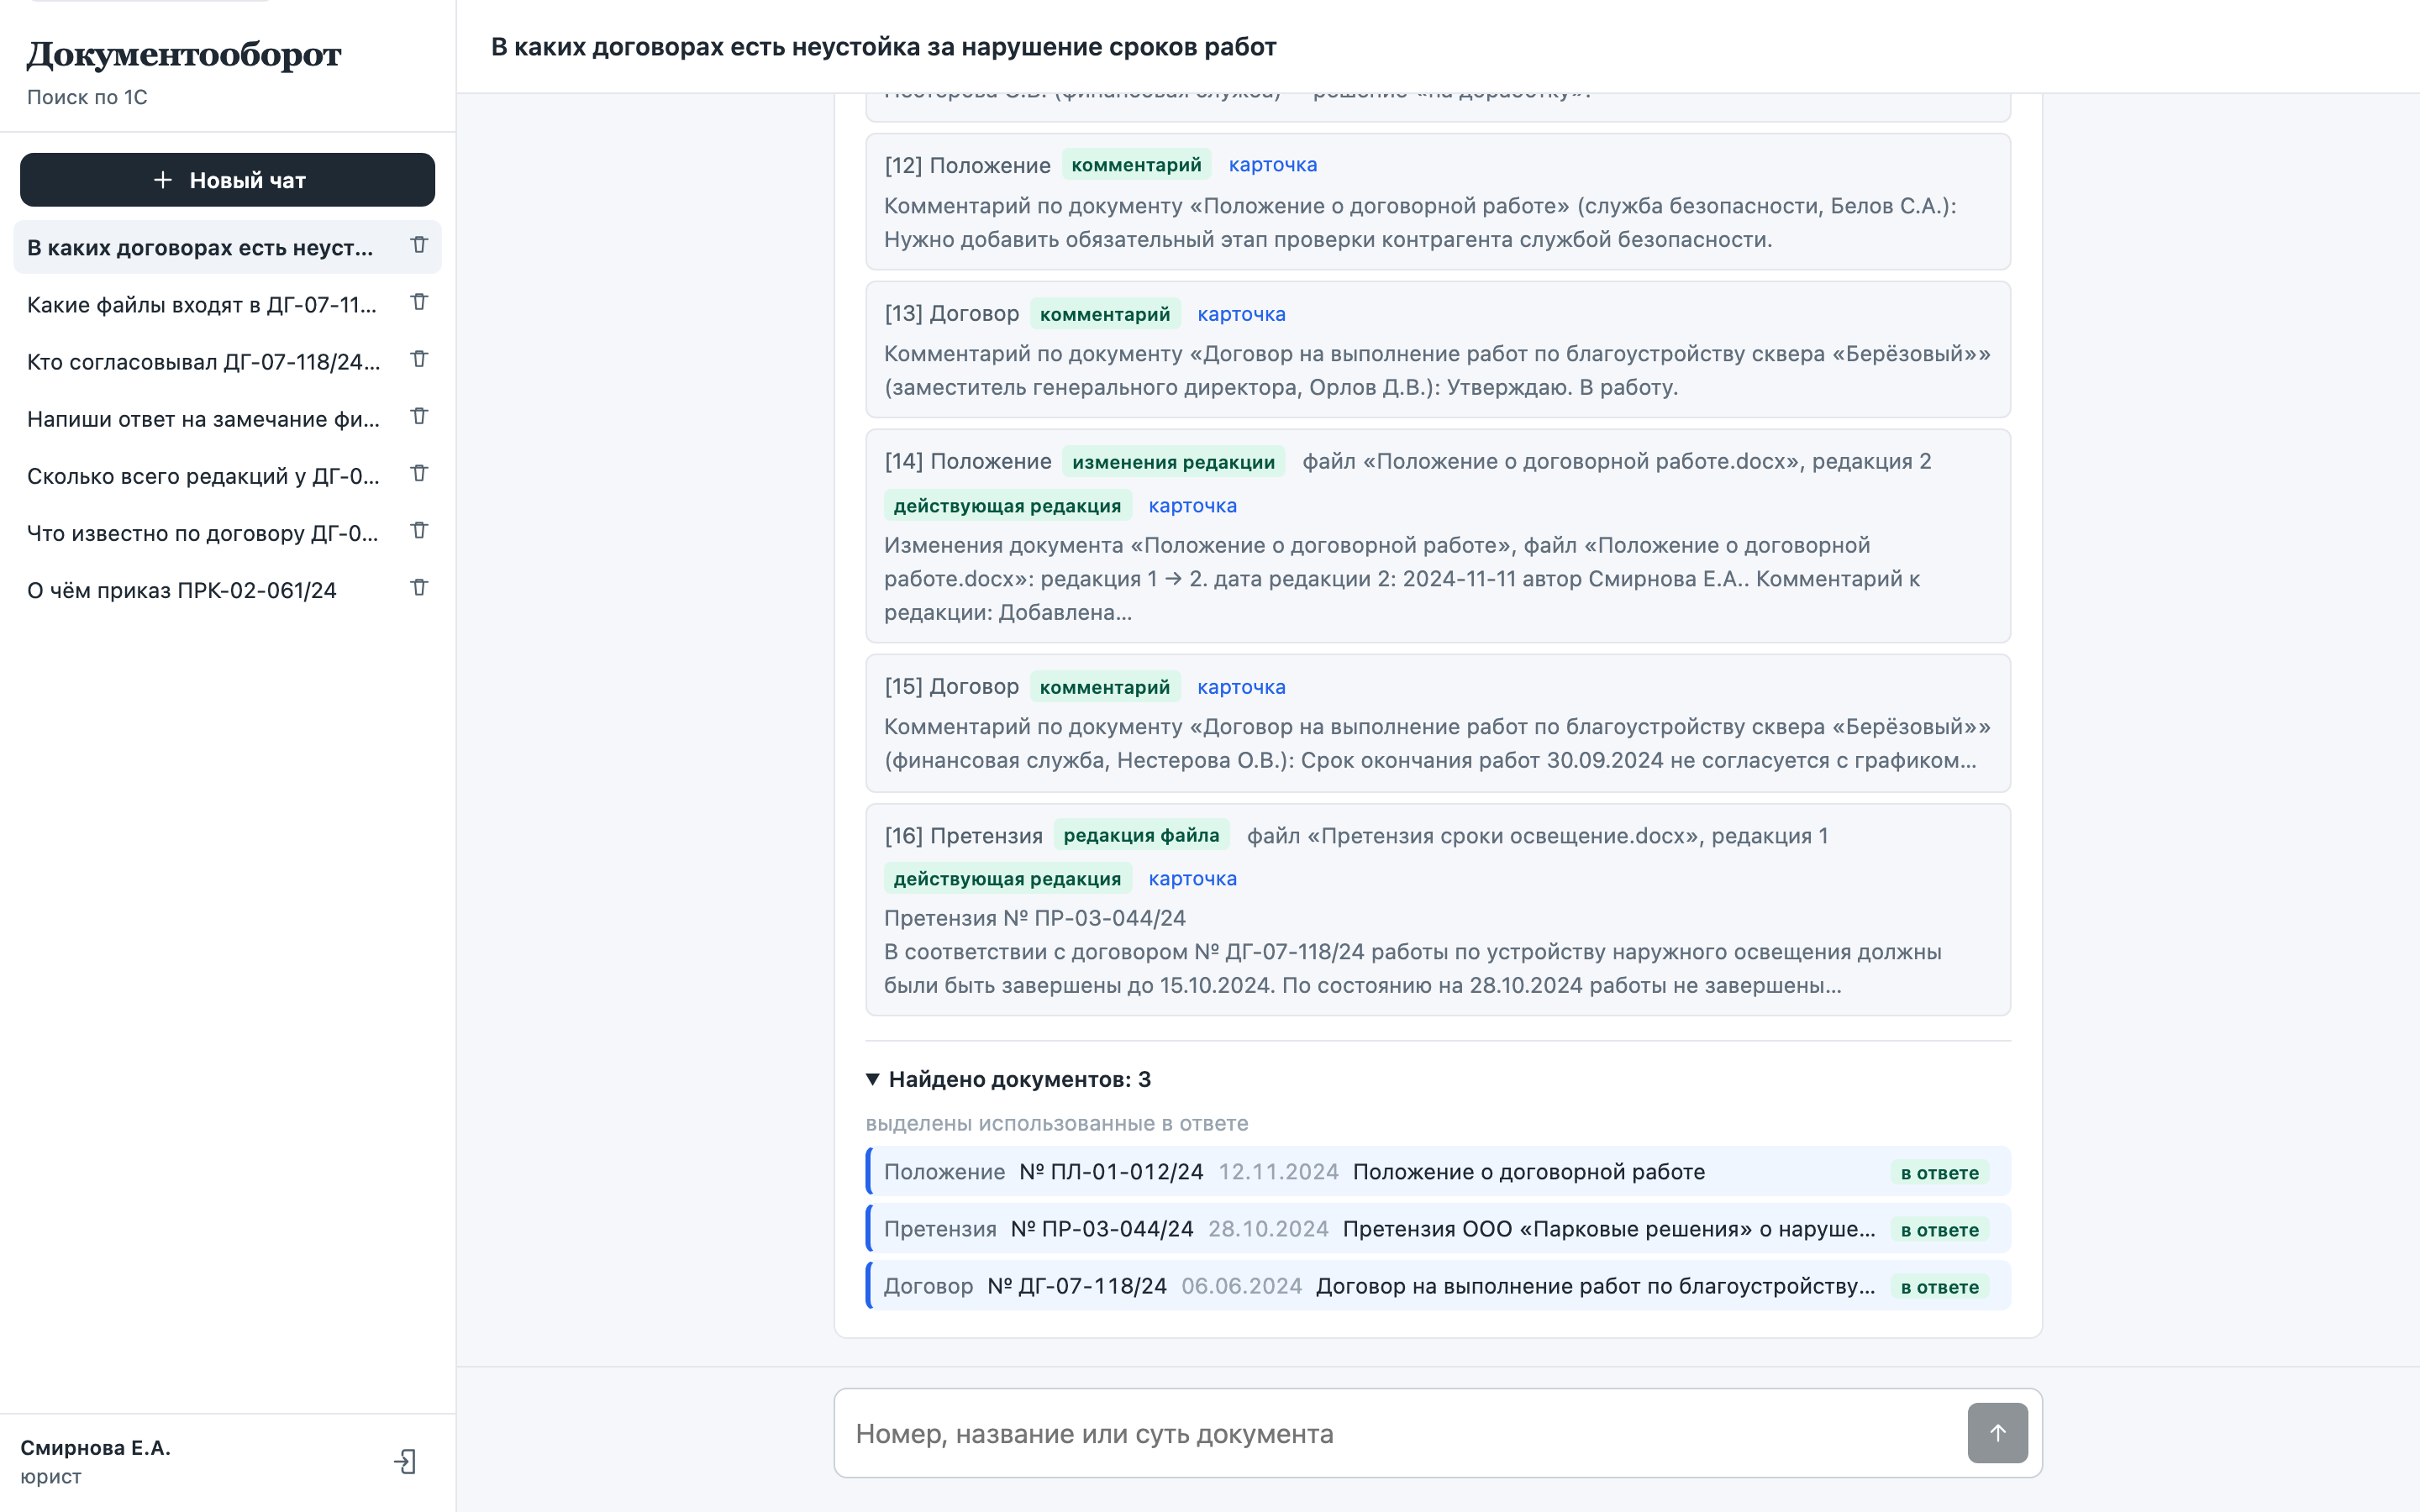
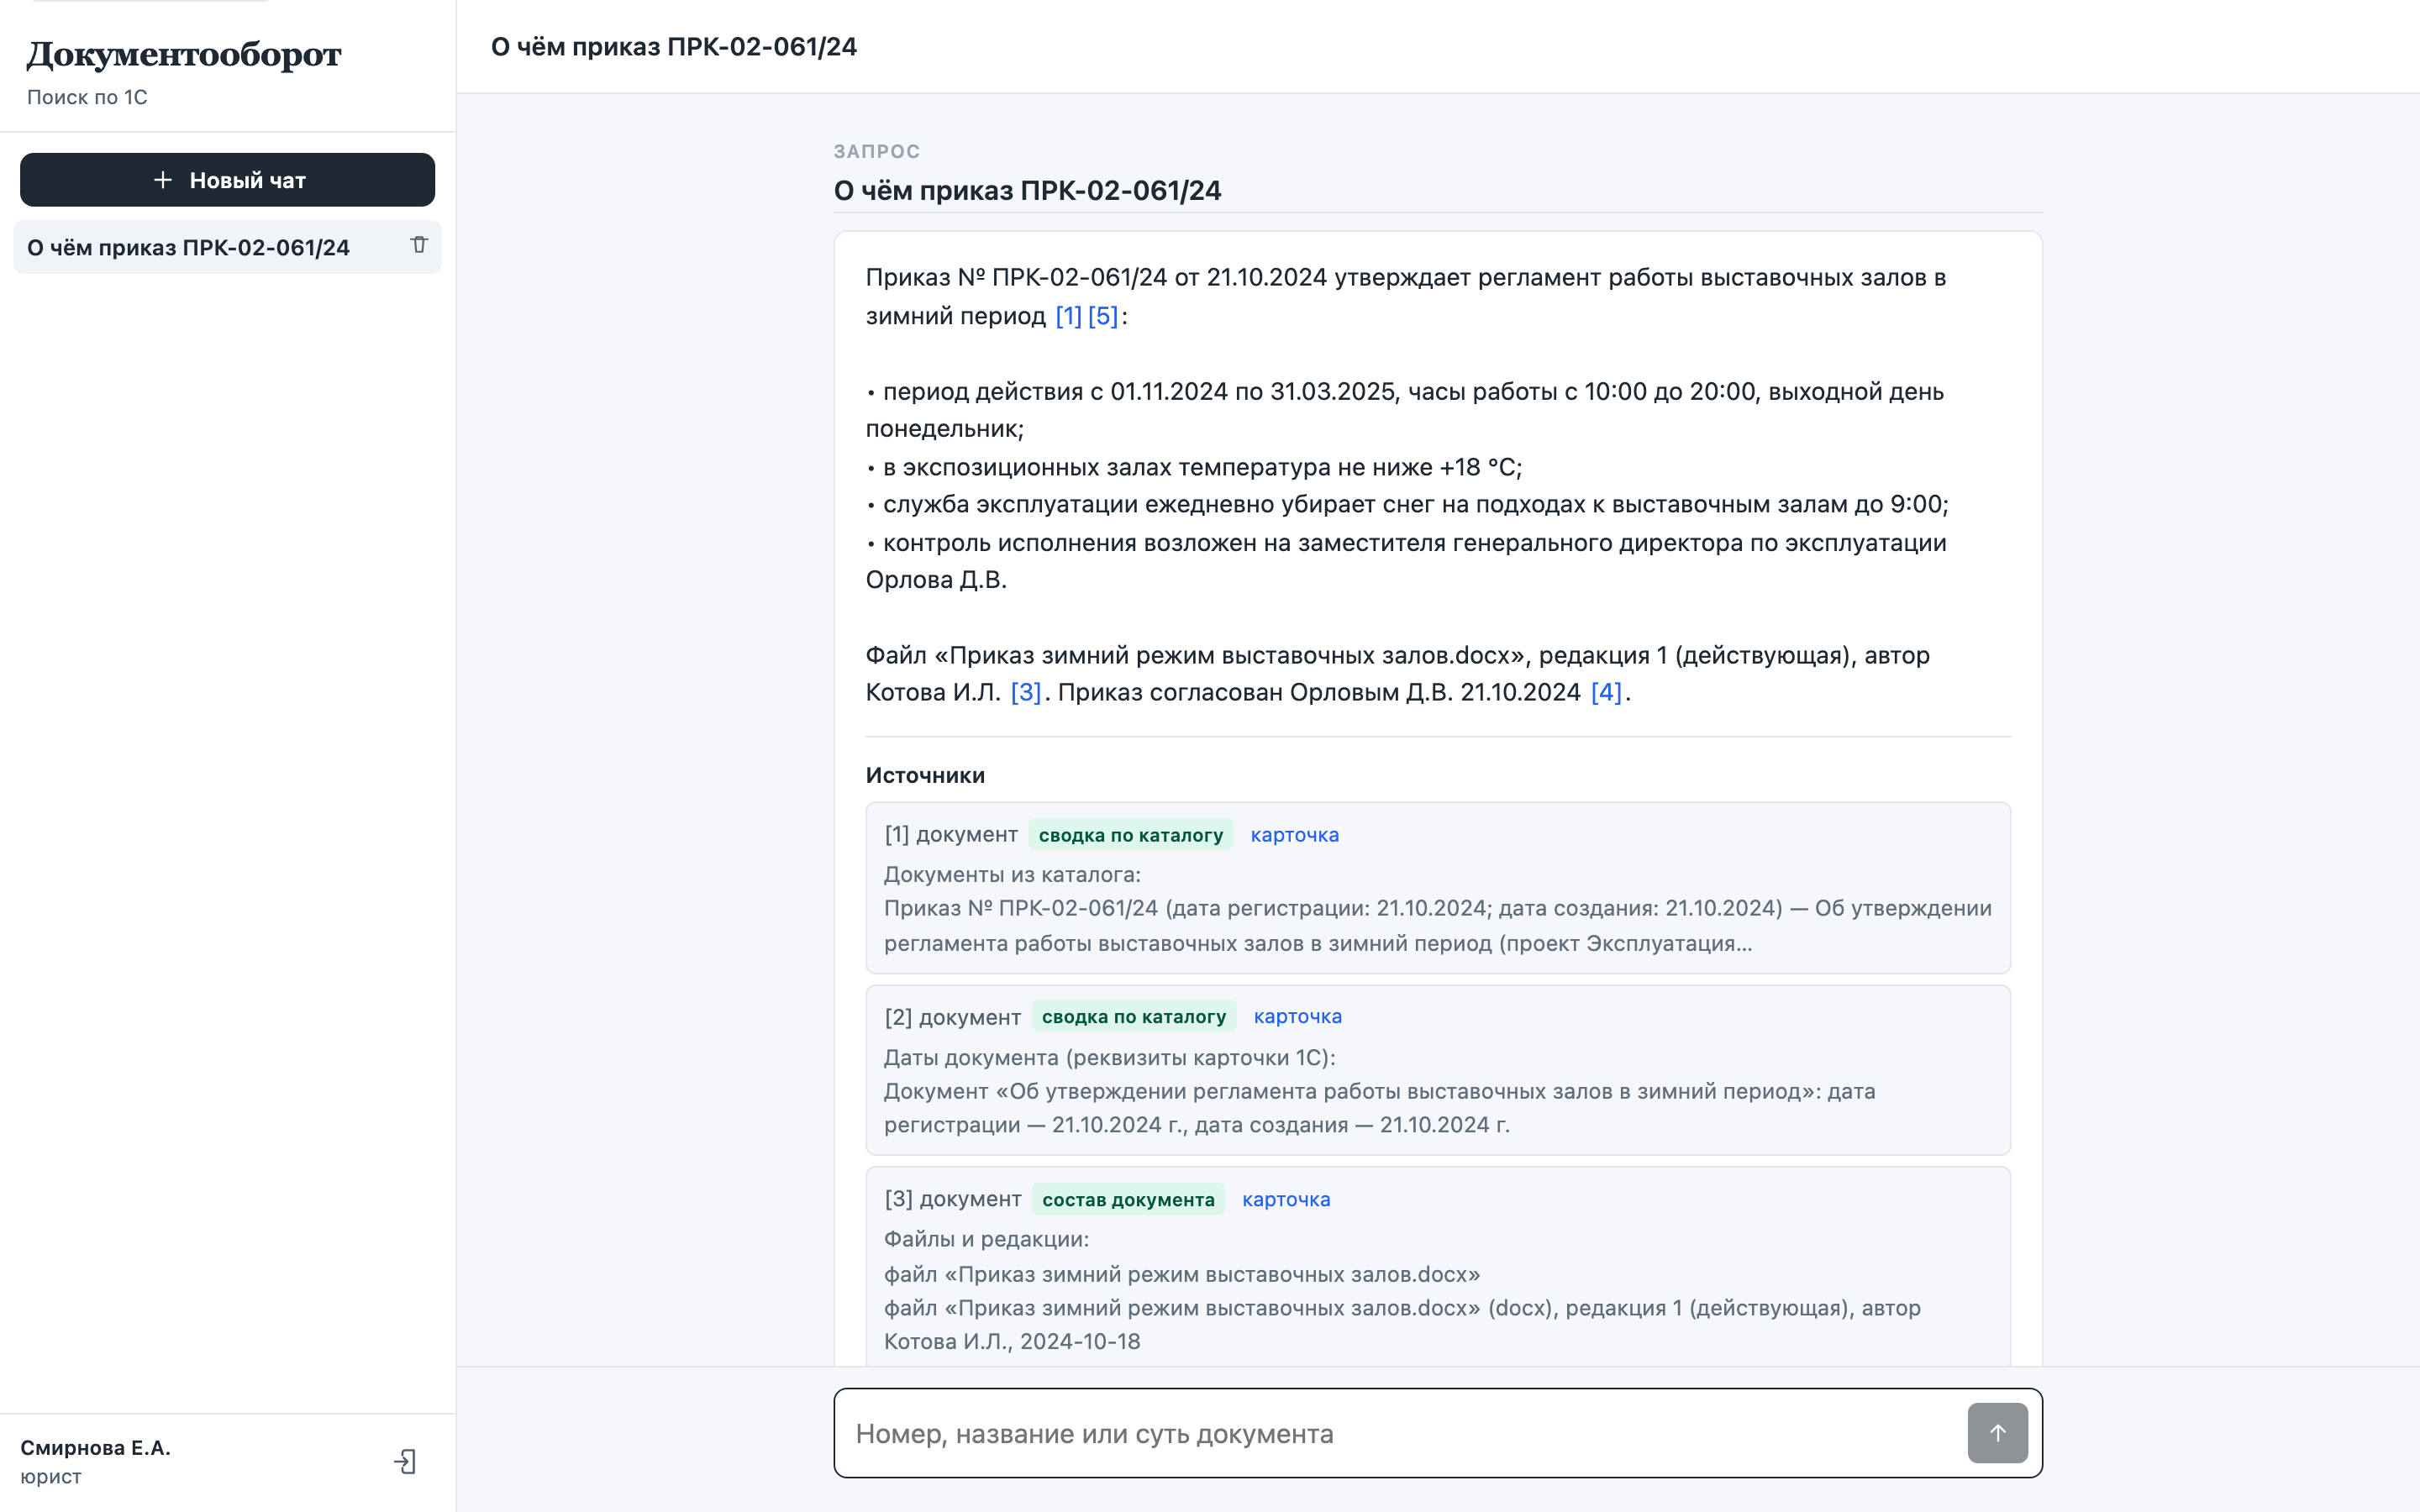
- Веб-интерфейс на React + TypeScript + Vite: чат со статусом запроса, источники под ответом, перечень найденных документов, копирование черновика
- Карточка документа: реквизиты, файлы и их редакции с действующей, согласования с цветом решений, комментарии, связанные документы
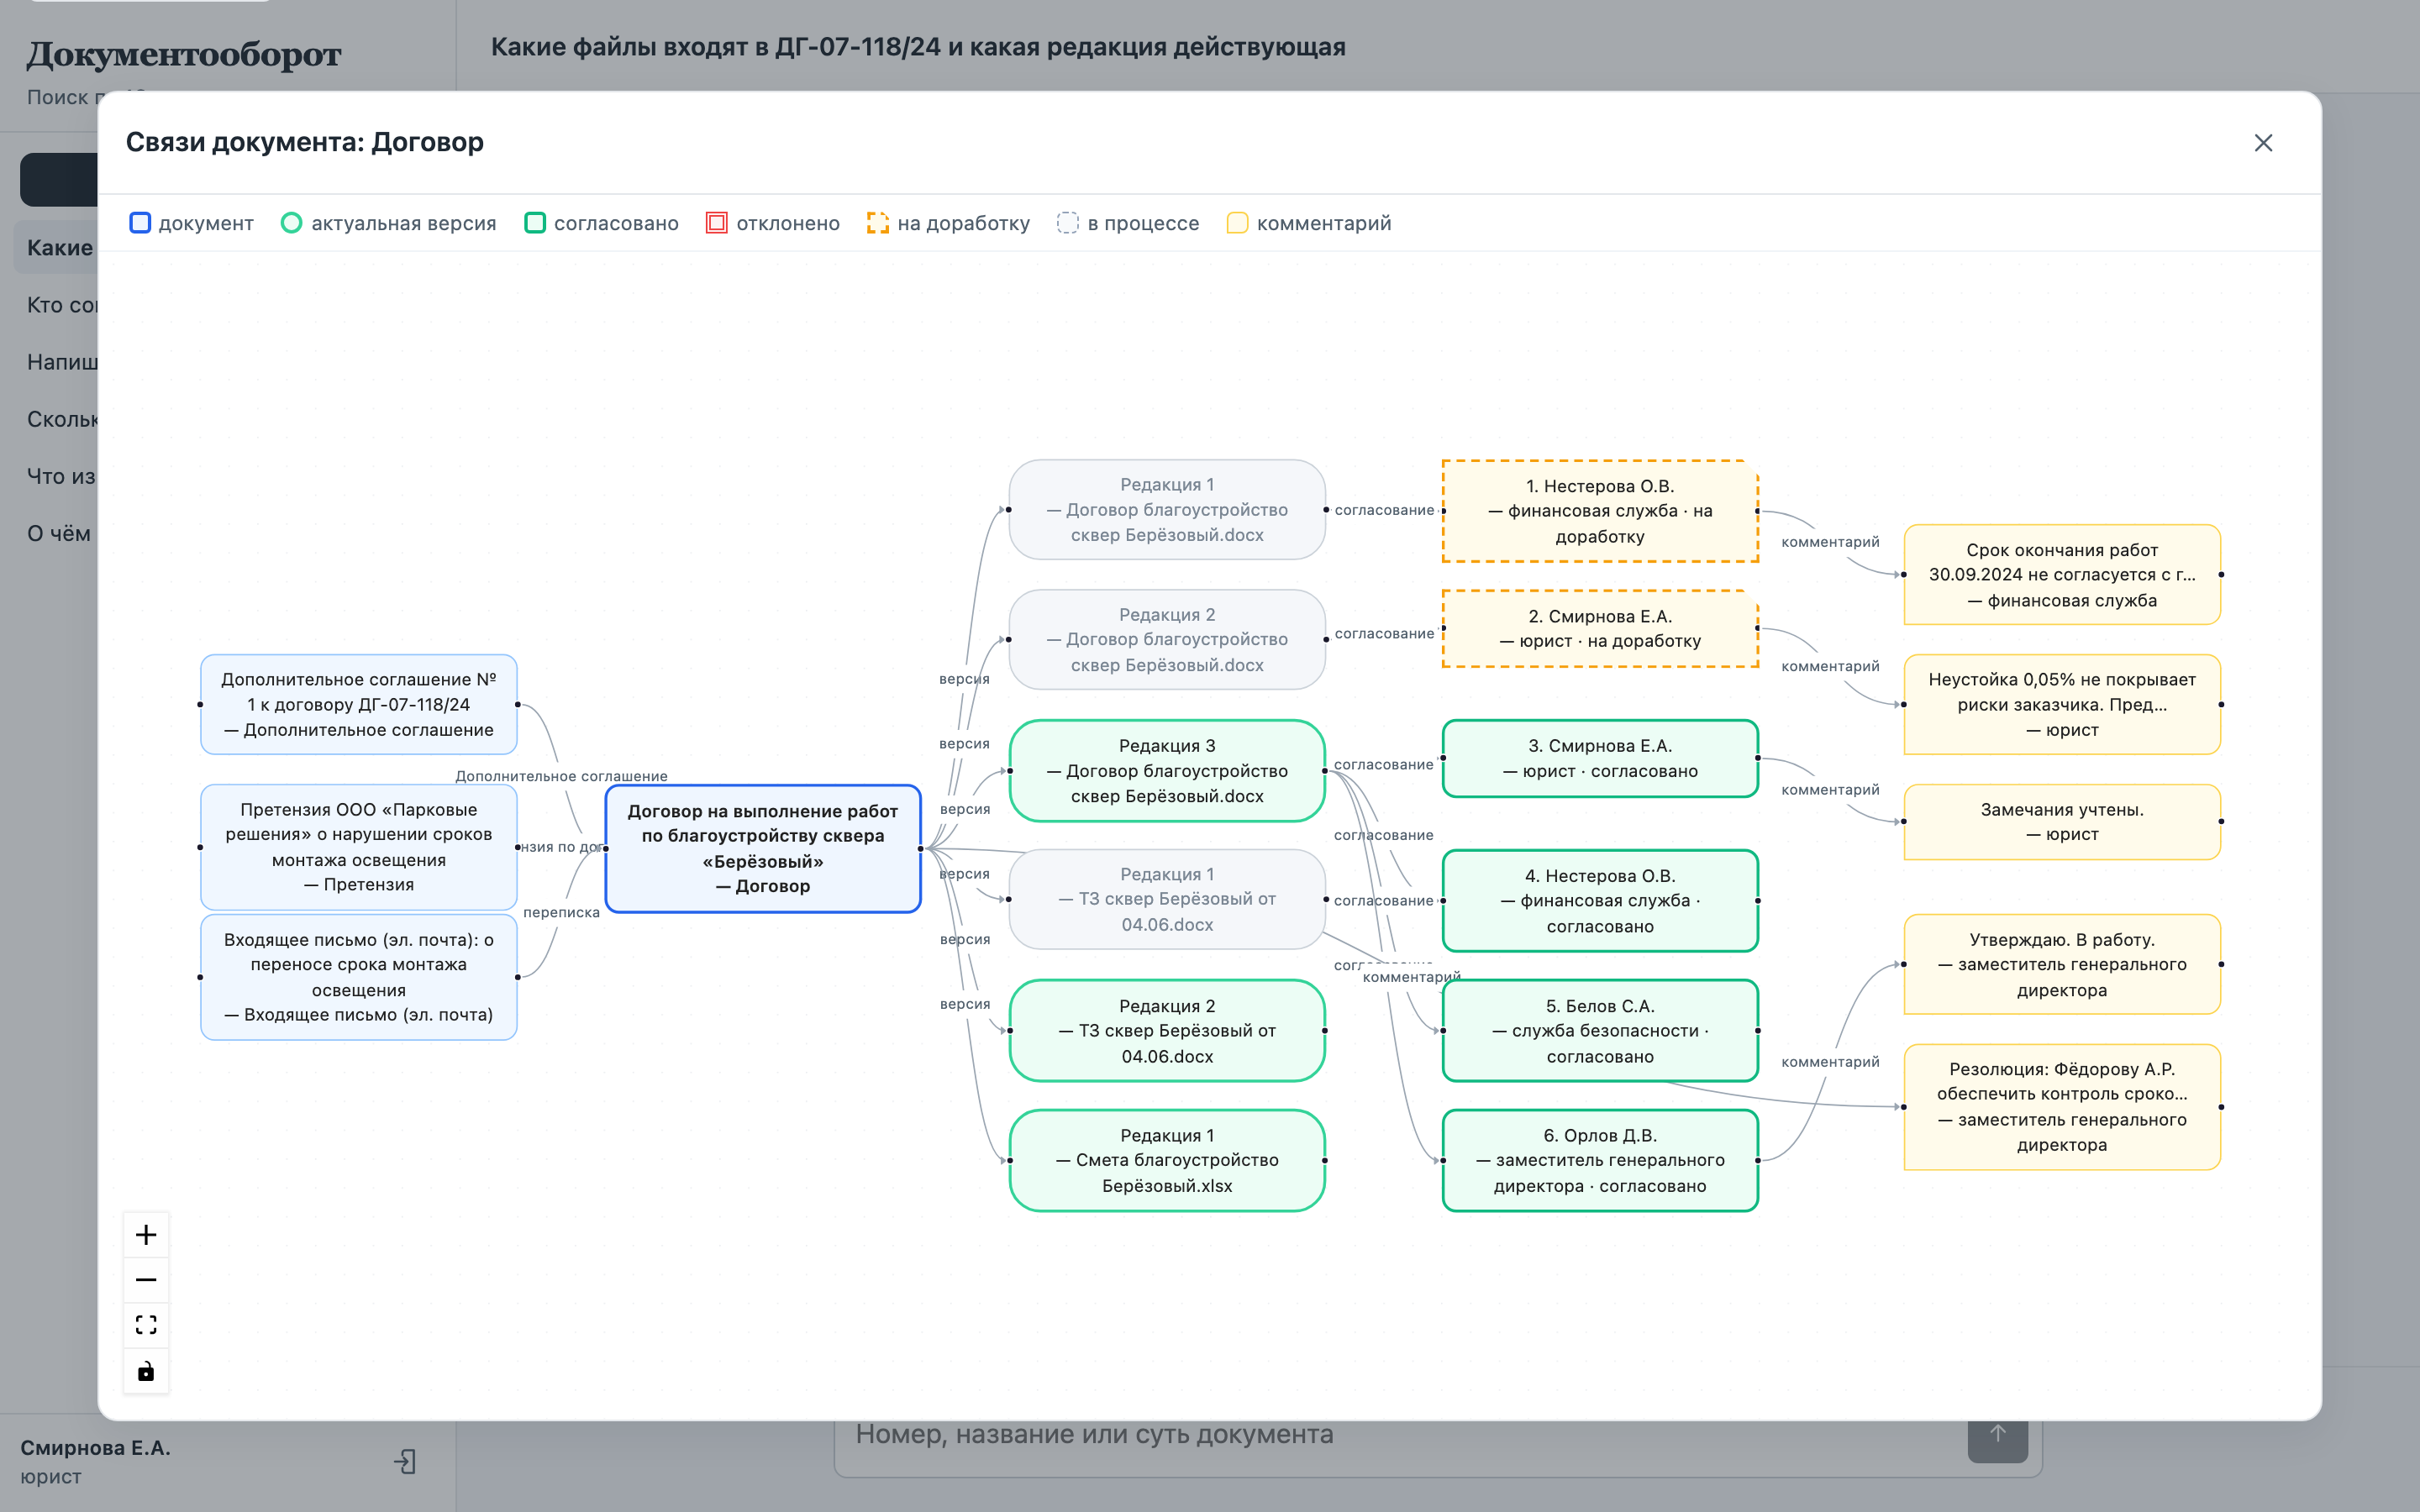
- Граф связей на React Flow: документ, редакции файлов, визы, комментарии и связанные документы
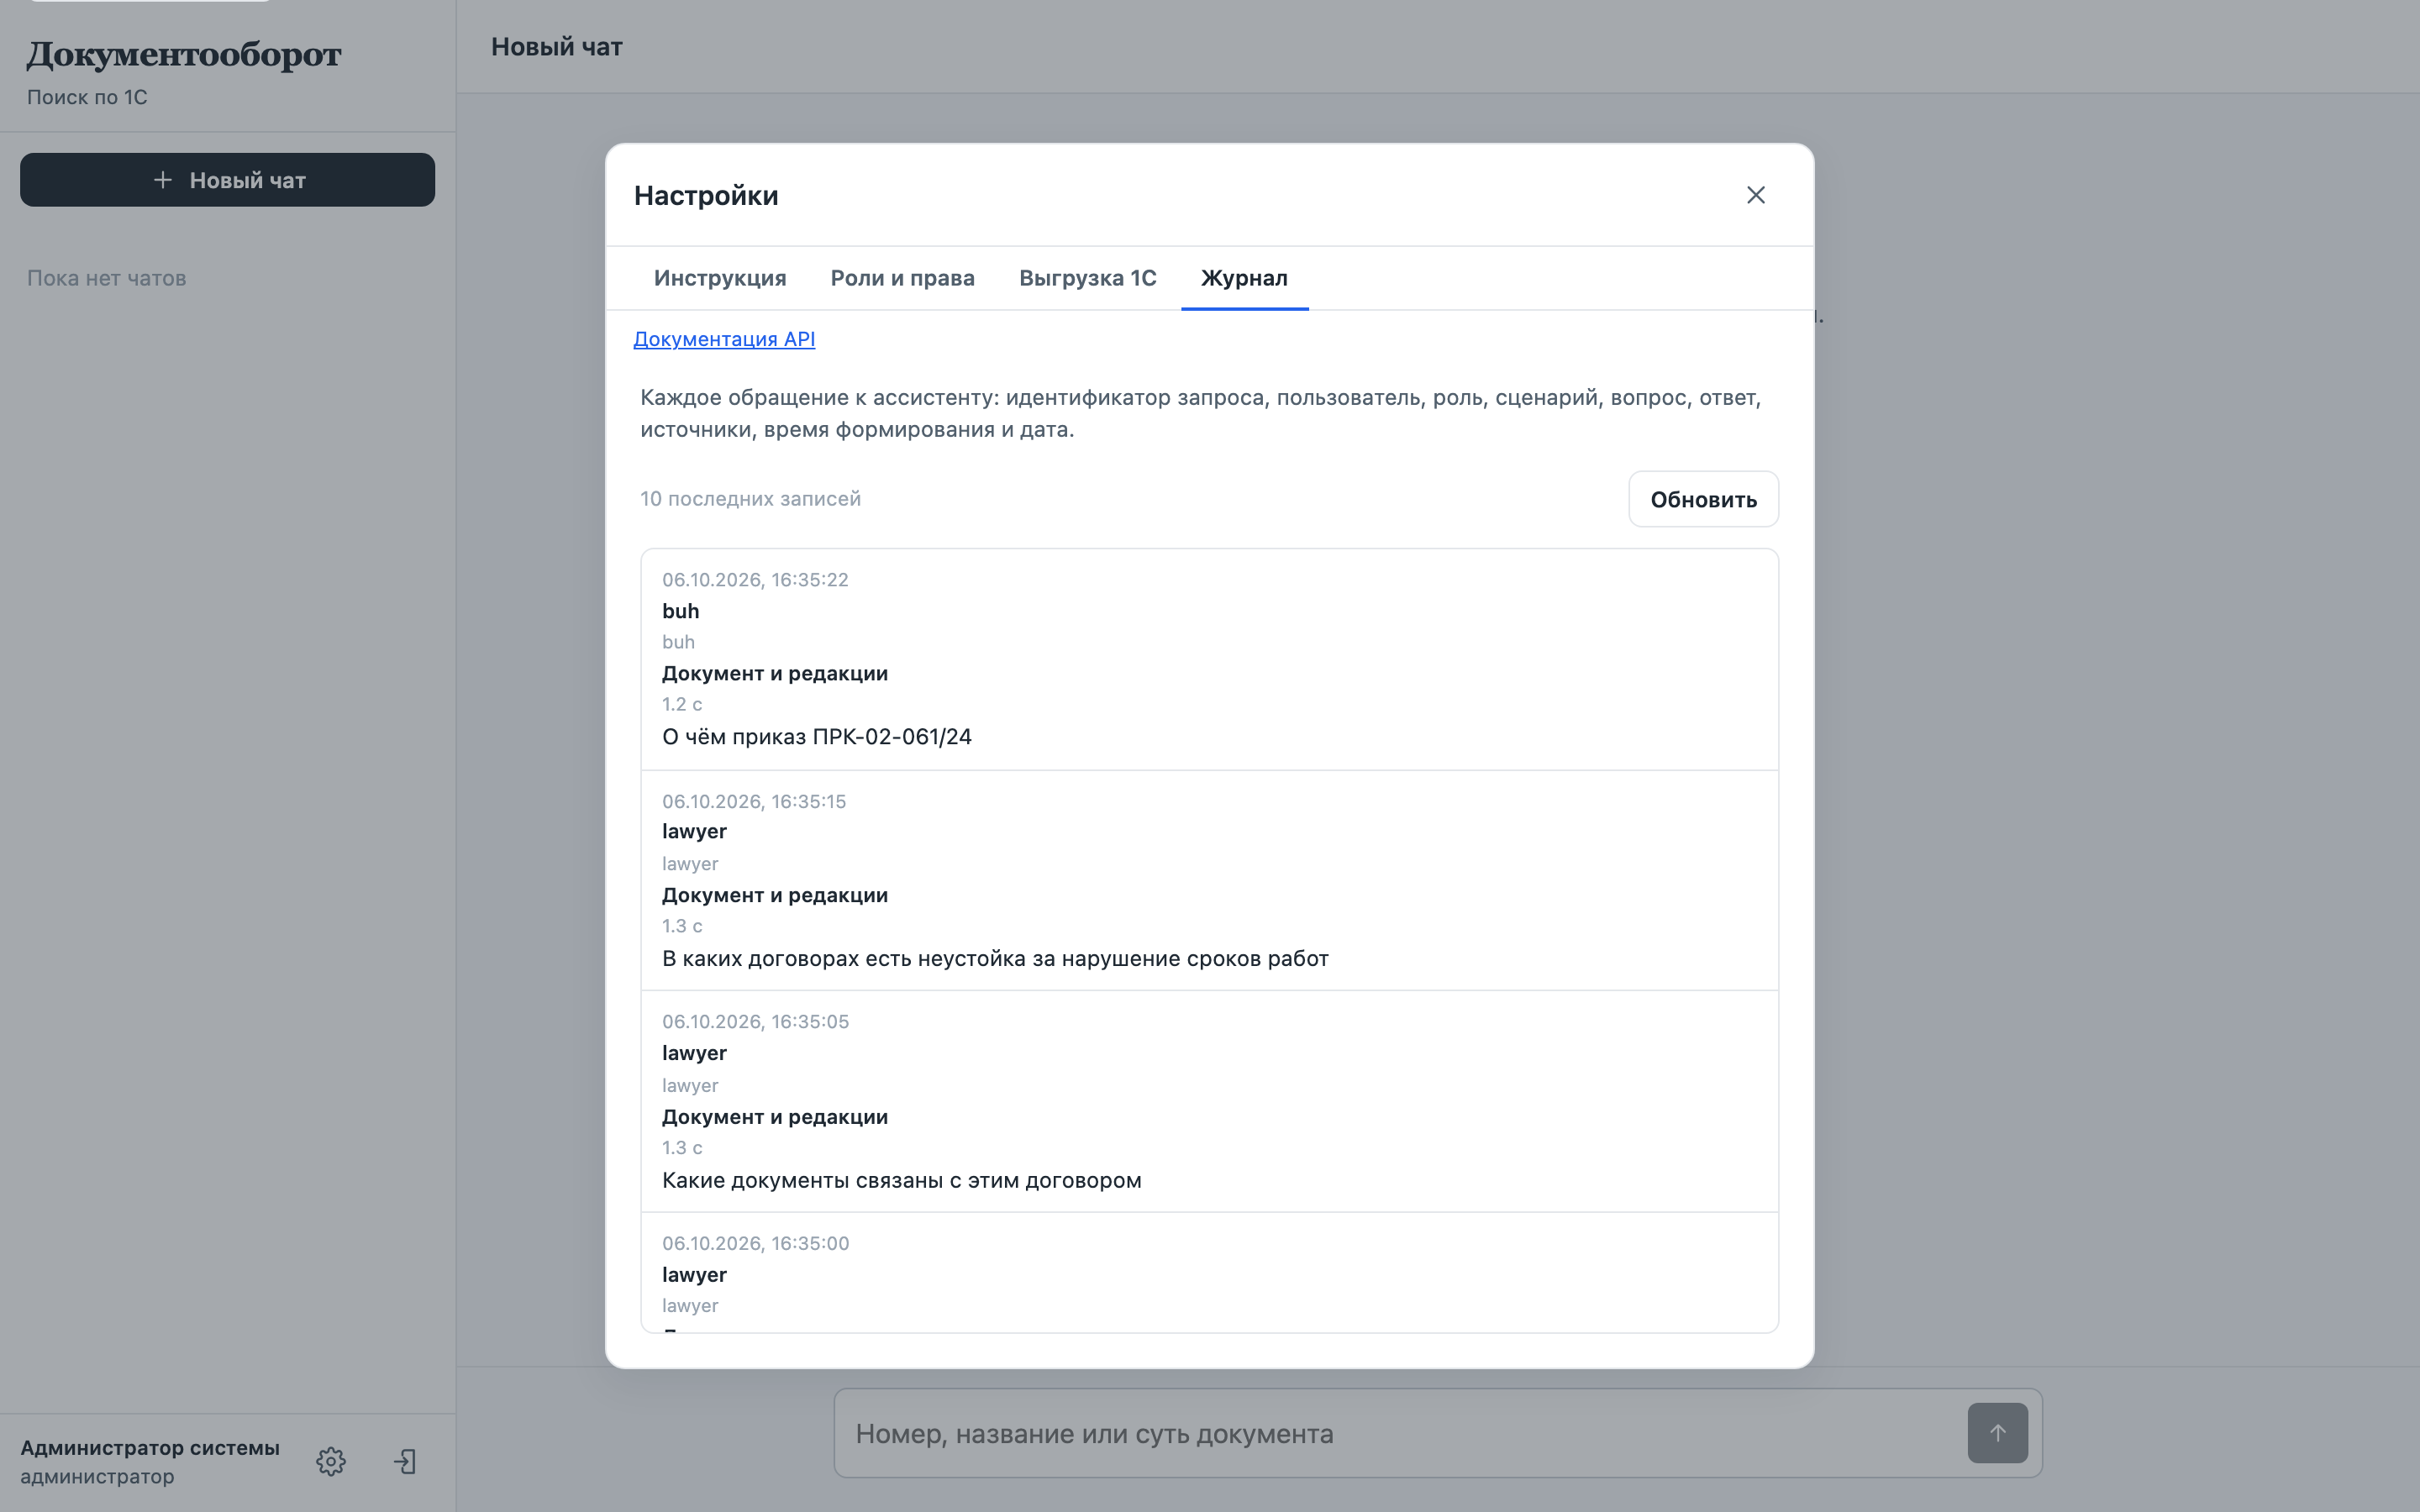
- Админ-панель: инструкция для ответов, роли и права, запуск выгрузки и переиндексации, расписание ночного прогона, журнал событий и журнал обращений
- Прогон выборки на сервере: по каждому документу задаются контрольные вопросы, ответы с источниками, вызовами расчёта и маршрутом сохраняются для оценки качества
- Наблюдаемость: метрики Prometheus, статус выгрузки и индекса по источникам фрагментов, журнал обращений с request_id, rate limiting
- Развёртывание: Docker Compose и Kubernetes-манифесты, миграции в initContainer, скрипты бэкапа и восстановления, 649 автотестов
Ключевые фичи
- Факты из базы, а не из модели: существование документа, состав файлов и число редакций определяет SQL-запрос к каталогу
- Ответ только по документам заказчика: если документа или текста файла нет, ассистент называет причину (скан, PDF без текстового слоя, текст не сохранён в 1С), а не сочиняет
- Ссылки на источники в каждом ответе: номер [1], [2] ведёт к фрагменту, рядом перечень найденных документов с пометкой, какие вошли в ответ
- Редакция принадлежит файлу: ответ идёт по файлам (файл, сколько у него редакций, какая действующая), как в самой 1С
- Гибрид смысла и реквизитов: BM25 ловит номера и фамилии, dense ловит формулировки по смыслу, RRF и reranker сводят их вместе
- Связи вместо совпадений: претензия или доп. соглашение находятся через регистр связей 1С, даже если номера договора в их тексте нет
- Счёт без ошибок: суммы редакций, разницы и сроки между датами считает код
- Единый чат с автомаршрутизацией: сценарий и источник данных определяются по вопросу, переключать режимы не нужно
- Полностью локальный контур: LLM, эмбеддинги, BM25 и reranker работают внутри периметра заказчика, без внешних API
- Работа без доступа к БД 1С: только OData-публикация, с обходом её ограничений
- Устойчивость к сбоям 1С: таймаут или 5xx на части сущностей не рушит прогон, недочитанное не пишется, прерванный прогон продолжается с пачки
- Ролевая видимость: закрытый роли вид документа не появится ни в поиске, ни в карточке, ни в графе
Решение задачи
Архив 1С:Документооборот стал источником, к которому сотрудники обращаются на естественном языке: юрист спрашивает про договор и получает состав файлов с действующими редакциями, изменения между редакциями, ход согласования, связанные документы и черновик ответа на замечание, со ссылками на источники вместо ручного обхода карточек в 1С.
Модель отделена от фактов: существование документа, файлы, редакции и согласующих определяет каталог, числа считает код, а при нехватке данных ассистент называет причину. Устойчивый конвейер выгрузки через OData держит архив около 182 тысяч документов актуальным по ночному расписанию без доступа к базе 1С.
Качество подтверждено прогоном на рабочем контуре: 2000 документов второго полугодия 2024 года (14 815 файлов, 31 604 редакции), 4000 вопросов о составе файлов и истории редакций, автоматическая сверка с эталоном из каталога и ручная проверка 600 пар редакций. Все основные метрики на уровне 95% и выше; единичные расхождения возникают только на шаге, где модель формулирует текст из уже верно подготовленных данных.
Метрики
Результаты
Синтетические данныеДанные на скриншотах вымышленные: реальные цифры, названия контрагентов и персональные данные заменены на синтетические.
Заказать похожий проект
Оставьте заявку, обсудим задачу и предложим решение под ваш бизнес.
Оставить заявкуДругие кейсы

CorpSoft24
Платформа защиты корпоративных AI-систем
Шлюз между корпоративными AI-продуктами и языковыми моделями: каждый запрос проходит маскирование персональных данных, поиск prompt injection, проверку по базе коммерческой тайны и LLM-судью, а администраторы заказчика видят журнал, инциденты и очередь подтверждений.

Министерство юстиции Российской Федерации
Классификатор обращений граждан – Минюст
Модуль на ансамбле из четырёх моделей RuBERT-large читает обращения граждан, поступившие через сайт Минюста России, определяет одну из 10 тематических рубрик и дописывает в регистрационную карточку коды рубрики и департамент-получатель. Работает в закрытом контуре заказчика, без интернета и без видеокарты.

Зеленопарк (ТЦ)
Зеленопарк ТЦ приложение
Мобильное приложение для посетителей ТЦ Зеленопарк: навигация по ТЦ, акции арендаторов, события и бонусные механики.

CorpSoft24
AI-агент «Пресейл-менеджер» для подготовки КП
Мультисервисный AI-ассистент для пресейл-команд: анализирует клиента, готовит коммерческие предложения и презентации на базе RAG и веб-исследования, с генерацией файлов DOCX/PDF.

CorpSoft24
AI-ассистент продуктового менеджера
MVP-платформа, где AI-агент уровня senior PM/CPO обрабатывает продуктовые задачи в чате асинхронно через очередь, использует RAG по документам и выгружает результат в Markdown/DOCX.

CorpSoft24
AI-советник по развитию существующих клиентов
Чат-советник на базе LLM, который анализирует корпоративные данные о клиенте и даёт факты и рекомендации по upsell/удержанию с уровнем уверенности, либо честно признаёт нехватку контекста.

Краеведческий музей г. Чернушка
Интерактивный стол «Родной край» для краеведческого музея
Киоск-приложение для сенсорного стола 4K: летопись нефтедобычи района, фотоархив, геология, карта месторождений и три обучающие игры, с админ-панелью прямо на столе и полностью офлайн-работой.

Вкусно и Точка
Бот для розыгрышей Вкусно и Точка в MAX
Монорепо-платформа для маркетингового бота в мессенджере MAX: массовые рассылки по аудитории, розыгрыши с проверкой подписки, онбординг пользователей и веб-панель администратора.

GoEvent
Промо-система розыгрыша автомобилей в ТЦ
Платформа для проведения розыгрыша автомобилей в ТЦ по всей России (чеки, регистрация, выбор победителей).

TriMoTi
Мобильное приложение TriMoTi для аудиогидов в музеях
Мобильное веб-приложение TriMoTi с аудиоэкскурсиями по музеям и городам: интерактивные карты залов и улиц, офлайн-режим, AI-гид с голосовыми вопросами и онлайн-продажа экскурсий.

Cyberly
Социальная сеть для киборгов (людей с ампутациями)
Социальная сеть и информационный портал для людей, потерявших конечности. Обмен опытом, поиск мастеров по протезированию, психологическая поддержка.

Культура гостеприимства
ИИ аттестация сотрудников и оценка кандидатов
Система для сети ресторанов: автоматическое аудиоинтервью для аттестации текущих сотрудников и ИИ-оценка soft skills кандидатов для HR.

Ист Трейд
ИИ генерация этикеток с проверкой по ТР ТС
Автоматическая генерация этикеток для импортных продуктов с переводом и валидацией по регламентам Таможенного Союза.

Samadashvili Winery
E-commerce платформа для винодельни Samadashvili
Двухконтурная Medusa-платформа для винодельни: брендовый Next.js storefront, каталог вин, корзина, checkout, Bank of Georgia, туры и кастомная админка.

ООО Умный Век
CRM-платформа для компании Umvek
Кастомная CRM-система для B2B-поставщика AV-оборудования: управление сделками, воронки продаж, финансовая аналитика, KPI и мотивация сотрудников.

Юридический сервис для бухгалтеров и юристов
Конструктор юридических документов с AI-проверкой
Платформа автогенерации договоров и государственных форм (включая полную форму Р13014 ФНС) с AI-чатом, который проверяет документы на соответствие нормативным требованиям.

UnoCode (внутренний продукт)
Платформа управления проектами и командой UnoProject
Операционная платформа для IT-студий: проекты, заказы, задачи, команда и документы в одном пространстве с ролевым доступом и прозрачностью для заказчика.

Wrapstore
Wrapstore – Бизнес-дашборд
Финансовая панель для группы торговых компаний: продажи из трёх баз 1С и выписки Т-Банка и Альфа-Банка сводятся в один управленческий отчёт с ежедневной сверкой, категориями расходов, расчётом ЗП менеджеров и дебиторкой.

UnoCode (внутренний продукт)
AI-платформа квалификации тендеров UnoTender
Лента закупок под нишу компании и ИИ-анализ документации: за минуты понятно, стоит ли участвовать в тендере.
Ассоциация выпускников и эндаумент-фонд гимназии №9 города Екатеринбург
Сервис ассоциации выпускников и эндаумент-фонда гимназии №9
Портал сообщества выпускников гимназии №9 (Екатеринбург): цифровой музей истории школы, поиск одноклассников, карта выпускников, встречи и приём пожертвований в эндаумент-фонд в одном сайте.
UnoCode (внутренний продукт)
AI-платформа оценки персонала Qualy
ИИ-аттестация сотрудников по голосовым и текстовым ответам: единый стандарт оценки во всех филиалах и аналитика по команде.
Turnix
Платформа для организации киберспортивных матчей
Платформа для автоматизации проведения киберспортивных турниров (сетка, лобби, проверка результатов).
Детская школа танцев
Система планирования расписания и зарплат для школы танцев
ERP-система для детской школы танцев: планирование расписания групп, расчет зарплат преподавателей с учетом KPI и посещаемости.
Оператор торгового центра
Платформа интерактивных карт торговых центров UnoMallMap
Единая система управления планом этажей, виджетом для сайта, сенсорными киосками и рекламой на инфоэкранах.
123-buh
ИИ сканер чатов и авто-задачи в Битрикс
Система в реальном времени сканирует все чаты с клиентами, выделяет задачи из потока сообщений, создает их в Битрикс24 ответственному бухгалтеру и формирует EOD-отчет.
ООО Умный Век
СпортТабло (Десктопная программа)
Десктопное приложение-табло для детских спортивных соревнований в школах, отображающее счет, таймер и состав команд на проекторе/экране.
HR- и рекрутинговые команды работодателей
AI-платформа оценки кандидатов UnoHR
ИИ-скоринг откликов и резюме с hh.ru: кандидаты отсортированы по соответствию вакансии, рекрутёр начинает с лучших.
ETC Trade (Ист Трейд)
AI-чат-бот для B2B- и B2C-клиентов ETC Trade
AI-чат-бот для мультиканальной поддержки B2B- и B2C-клиентов: консультации по ассортименту, доставке и условиям, квалификация лидов и передача в Bitrix24.
Тримет
ИИ-чат-бот для Авито и сайта (металлопрокат)
Чат-бот для оптово-производственной компании по металлу, знающий весь ассортимент и умеющий оформлять заявки прямо в чате Авито и на сайте.
Arhat Inks (Узбекистан)
VIP AI-менеджер для производителя красок
ИИ-агент для работы с текущими и VIP-клиентами: распознавание узбекской речи, проверка дебиторки, формирование заказов и рекомендации ассортимента.
ООО Белтимпэкс
Распознавание заказов из файлов клиентов
Программа для автоматического распознавания позиций заказа из любых файлов (Excel, PDF, фото) с поиском по базе номенклатуры и отправкой готового заказа в 1С.
Белтимпэкс
Чат-бот с остатками из 1С
ИИ чат-бот для клиентов оптовой компании, который в реальном времени показывает наличие приводных ремней и их цену из базы 1С.